
用于学习的大数据集群环境搭建(上)
用于学习的大数据集群环境搭建(上)
最近学习用的集群连续出现问题,用的时间有点长了,东西太多,于是推倒重建,顺便复习温故
1 准备
1.1 虚拟机设置
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| hostname | node1.lvm-domain | node2.lvm-domain | node3.lvm-domain |
| ip | 172.31.31.51 | 172.31.31.52 | 172.31.31.53 |
| CPU内核数 | 4 | 2 | 2 |
| 内存 | 4 | 2 | 2 |
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
1.2 系统安装
CentOS-7-2009 最小化安装
使用 “DHCP-保留地址” 的方式固定 IP 地址
关机,快照 000
1.3 安装常用工具,update
yum install -y nano wget tree sysstat net-tools bind-utils traceroute git make gcc gcc-c++ openssl

yum clean all
yum makecache
yum update -y
yum upgrade -y
关机,快照 001
1.4 关防火墙、SELinux
systemctl stop firewalld
systemctl disable firewalld
systemctl status firewalld

nano /etc/selinux/config
	# 修改如下内容
reboot#SELINUX=enforcing
SELINUX=disabled
1.5 SSH 免密登录
-
修改 host 文件
-
echo 172.31.31.51 node1 >> /etc/hosts
echo 172.31.31.52 node2 >> /etc/hosts
echo 172.31.31.53 node3 >> /etc/hosts

less /etc/hosts
-
-
三台主机,分别生成密钥
-
ssh-keygen -t rsa
ls -Alph ~/.ssh
-
-
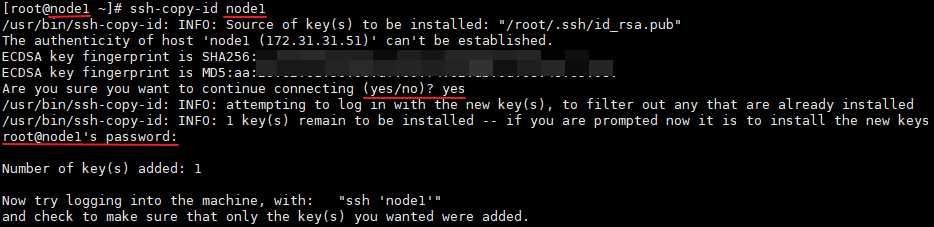
三台主机,分别将各自的公钥,拷贝给 node1:
-
ssh-copy-id node1 # 每台主机(包括 node1 自己)第一次以 ssh 协议连接到 node1 需要输入 yes 进行密钥确认,并输入 node1 的 root 密码 # 验证:在 node1 上检查 cat ~/.ssh/authorized_keys cat ~/.ssh/known_hosts -
001
-
-
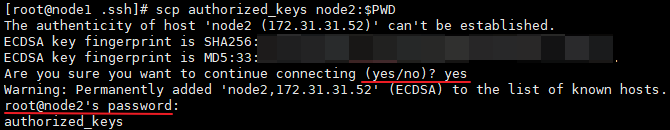
将 authorized_keys ,分发给另外两台主机
-
cd ~/.ssh scp authorized_keys node2:$PWD scp authorized_keys node3:$PWD # node1 第一次以 ssh 协议连接到另外两台节点,同样需要输入 yes 进行密钥确认,并输入目标节点的 root 密码 -
002
-
-
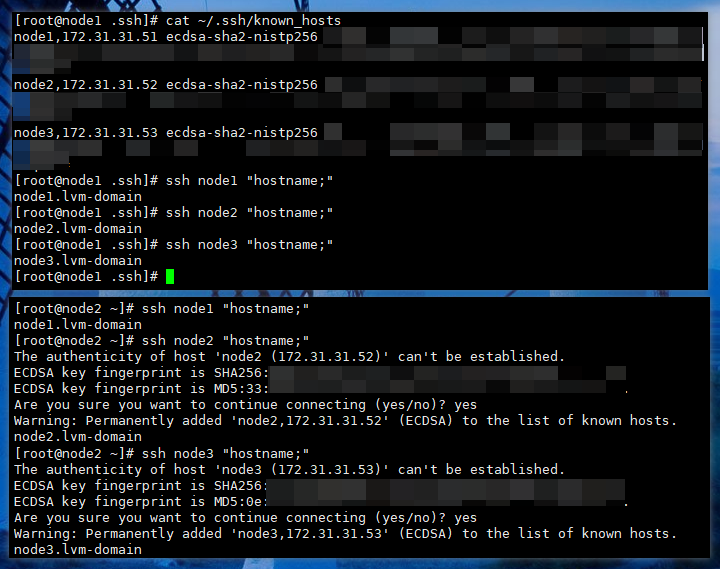
验证:三台主机之间,再通过ssh互相登录,不再需要输入密码
-
ssh node1 "hostname;" ssh node2 "hostname;" ssh node3 "hostname;" -
此时:
- 由于 node1 上已经有全部主机的密钥,并且在步骤 3 确认过本机的密钥,在步骤 4 确认过另外两台主机的密钥,所以全部能够直接登录
- 此时另外两台主机也有了全部主机的密钥,并且在步骤 3 确认过 node1 的密钥,所以无需确认直接登录;但对其他主机,还是第一次连接,需要进行确认(但因为有了密钥,不需要输入密码)
003
-
关机,快照 002
1.6 对时
暂时没做这步。一般情况下虚拟机直接从(同一个)硬件时钟获取时间,应该不存在时间不同步的问题
1.7 准备目录和脚本
# 每个节点都执行
mkdir -p /opt/data
mkdir -p /opt/conf
mkdir -p /opt/logs
mkdir -p /opt/apps
mkdir -p /opt/custom_shell

mkdir -p /home/root/opt_software
mkdir -p /home/root/opt_test
	# 没手动分区,被分了一半空间到 home 目录,暂且建个软链接使用
ln -s /home/root/opt_software/ software
ln -s /home/root/opt_test/ test

tree -L 1 /opt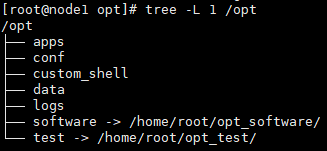
给脚本目录设置一下环境变量 $CS ,和执行权限
cp /etc/profile /etc/profile.bak
echo " " >> /etc/profile
echo "# custom_shell" >> /etc/profile
echo "export CS=/opt/custom_shell" >> /etc/profile
source /etc/profile
echo $CS

# 上传/编写脚本(略)
# 给将本目录设置执行权限
chmod 700 -R $CS
ls -Alph $CS

# 测试
$CS/du.sh
脚本见最后的附录
2 集群规划
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| hostname | node1.lvm-domain | node2.lvm-domain | node3.lvm-domain |
| ip | 172.31.31.51 | 172.31.31.52 | 172.31.31.53 |
| CPU内核数 | 4 | 2 | 2 |
| 内存 | 4 | 2 | 2 |
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
| ———- | ———- | ———- | ———- |
| »> ZooKeeper : | ✔ | ✔ | ✔ |
| ———- | ———- | ———- | ———- |
| »> Hadoop : | |||
| JournalNode | ✔ | ✔ | ✔ |
| NameNode | ✘ | ✔ | ✔ |
| SecondaryNameNode | ✘ | ✘ | ✘ |
| DataNode | ✔ | ✔ | ✔ |
| ResourceManager | ✘ | ✔ | ✔ |
| NodeManager | ✔ | ✔ | ✔ |
| JobHistoryServer | ✔ | ✘ | ✘ |
| ———- | ———- | ———- | ———- |
| »> HIVE(远程部署模式): | |||
| MetadataDB(MySQL) | ✔ | ✘ | ✘ |
| Hive Client(非常驻) | ✔ | ✔ | ✔ |
| Metastore | ✔ | ✘ | ✘ |
| HiveServer2(用到再装) | (✔) | ✘ | ✘ |
| Beeline Client(非常驻,可连H2) | (✔) | (✔) | (✔) |
| HCatalog(非常驻,不常用) | (✔) | (✔) | (✔) |
| ———- | ———- | ———- | ———- |
| »> Tez(无后台服务): | ✔ | ✔ | ✔ |
| ———- | ———- | ———- | ———- |
| »> Flume(无后台服务): | ✔ | ✔ | ✔ |
| ———- | ———- | ———- | ———- |
| »> DataX(无后台服务): | ✔ | ✔ | ✔ |
3 安装 JDK
-
下载(略)
-
解压
-
cd /opt/software/
ls
tar -zxvf openjdk-8u41-b04-linux-x64-14_jan_2020.tar.gz
ls
mv java-se-8u41-ri/ /opt/apps/open_jdk8u41
ls
ls /opt/apps/
-
-
配置环境变量,并同步到其他主机
-
# 配置环境变量
echo " " >> /etc/profile
echo "# OpenJDK" >> /etc/profile
echo "export JAVA_HOME=/opt/apps/open_jdk8u41" >> /etc/profile
echo "export CLASSPATH=.:\${JAVA_HOME}/jre/lib/rt.jar:\${JAVA_HOME}/lib/dt.jar:\${JAVA_HOME}/lib/tools.jar" >> /etc/profile
echo "export PATH=\$PATH:\${JAVA_HOME}/bin" >> /etc/profile

# 同步到其他主机
$CS/rsync.sh /opt/apps/open_jdk8u41
$CS/rsync.sh /etc/profile
-
-
在每台主机上刷新环境变量并验证
-
source /etc/profile
echo $JAVA_HOME
java -version
-
4 安装 ZooKeeper
4.1 规划
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
| »>ZooKeeper: | ✔ | ✔ | ✔ |
4.2 安装
-
下载(略)
-
解压
-
cd /opt/software/
ls
tar -zxvf zookeeper-3.4.14.tar.gz
ls
mv zookeeper-3.4.14/ /opt/apps
ls
ls /opt/apps/
-
-
配置
-
# 创建 data 目录 mkdir -p /opt/data/zk # 创建 log 目录 mkdir -p /opt/logs/zk # 修改配置文件 cd /opt/apps/zookeeper-3.4.14/conf ls cp zoo_sample.cfg zoo.cfg nano /opt/apps/zookeeper-3.4.14/conf/zoo.cfg # 编辑配置文件(内容如下) -
# 指定 data 与 log 目录
dataDir=/opt/data/zk
dataLogDir=/opt/logs/zk

# 配置集群节点
# server.服务器 ID = 服务器(主机名或 IP ):通信端口:选举端口
server.1=node1:2888:3888
server.2=node2:2888:3888
server.3=node3:2888:3888

# 自动清理事务日志和快照文件的间隔时间(小时)
autopurge.purgeInterval=24
-
-
添加环境变量
-
# 配置环境变量
echo " " >> /etc/profile
echo "# ZooKeeper" >> /etc/profile
echo "export ZK_HOME=/opt/apps/zookeeper-3.4.14" >> /etc/profile
echo "export PATH=\$PATH:\$ZK_HOME/bin" >> /etc/profile
-
-
同步
-
$CS/rsync.sh /opt/apps/zookeeper-3.4.14
$CS/rsync.sh /etc/profile

# 各主机上刷新环境变量,并验证
source /etc/profile
echo $ZK_HOME
-
-
给各节点设置 ID
-
ssh node1 "echo 1 >  /opt/data/zk/myid;"
ssh node2 "echo 2 >  /opt/data/zk/myid;"
ssh node3 "echo 3 >  /opt/data/zk/myid;"
-
4.3 启动和验证
-
启动
-
$CS/zk.sh start
	# stop 参数,关闭
	# status 参数,查看状态
-
-
使用
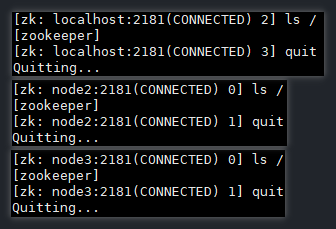
zkCli.sh客户端进行,各节点都能打开zkCli.sh客户端(但平常在 node1 上操作)-
zkCli.sh # 连接到本地服务器的默认端口(2181) # zkCli.sh -server {主机名|IP}[:port] zkCli.sh -server node2:2181 zkCli.sh -server node3:2181 -
005
-
-
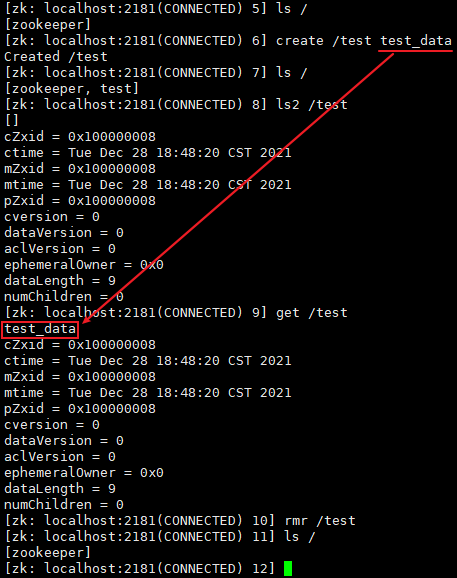
读写测试:
006
关机,快照 003
5 安装 Hadoop
5.1 规划
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
| »>Hadoop: | |||
| JournalNode | ✔ | ✔ | ✔ |
| NameNode | ✘ | ✔ | ✔ |
| SecondaryNameNode | ✘ | ✘ | ✘ |
| DataNode | ✔ | ✔ | ✔ |
| ResourceManager | ✘ | ✔ | ✔ |
| NodeManager | ✔ | ✔ | ✔ |
| JobHistoryServer | ✔ | ✘ | ✘ |
5.2 安装
5.2.1 下载解压
# 下载(略)

cd /opt/software/
ls
tar -zxvf hadoop-2.10.1.tar.gz
ls
mv hadoop-2.10.1/ /opt/apps
ls
ls /opt/apps/
5.2.2 HDFS 与 Core 配置
-
Hadoop 配置文件目录
-
cd /opt/apps/hadoop-2.10.1/etc/hadoop/
ls
-
-
修改
hadoop-env.sh-
nano hadoop-env.sh # 指定 JDK 目录 -
#export JAVA_HOME=${JAVA_HOME}
export JAVA_HOME=/opt/apps/open_jdk8u41
-
-
修改
core-site.xml-
mkdir -p /opt/data/hadoop nano core-site.xml -
<configuration>

    <!-- 指定 Hadoop 运行时产生文件的存储目录 -->
    <property>
        <name>hadoop.tmp.dir</name>
        <value>/opt/data/hadoop</value>
    </property>

    <!-- 非 HA 模式指定 HDFS 中 NameNode 的地址 -->
    <!-- <property> -->
        <!-- <name>fs.defaultFS</name> -->
        <!-- <value>hdfs://node2:9000</value> -->
    <!-- </property> -->

    <!-- 以下为 HA 集群配置 -->
    <property>
        <name>fs.defaultFS</name>
        <value>hdfs://hdfscluster</value>
    </property>

    <property>
        <name>ha.zookeeper.quorum</name>
        <value>node1:2181,node2:2181,node3:2181</value>
    </property>

</configuration>
-
-
修改
hdfs-site.xml-
mkdir -p /opt/data/journalnode nano hdfs-site.xml -
<configuration>

    <!-- 指定 secondary namenode 主机配置( HA 模式不需要) -->
    <!-- <property> -->
        <!-- <name>dfs.namenode.secondary.http-address</name> -->
        <!-- <value>node3:50090</value> -->
    <!-- </property> -->

    <!-- 副本数量 -->
    <property>
        <name>dfs.replication</name>
            <value>3</value>
    </property>

    <!-- 关闭 hdfs 文件权限验证(Web、HUE...) -->
    <property>
        <name>dfs.permissions.enabled</name>
        <value>false</value>
    </property>

    <!-- 以下为 HA 集群配置 -->
    <property>
        <name>dfs.nameservices</name>
        <value>hdfscluster</value>
    </property>

    <property>
        <name>dfs.ha.namenodes.hdfscluster</name>
        <value>nn2,nn3</value>
    </property>

    <property>
        <name>dfs.namenode.rpc-address.hdfscluster.nn2</name>
        <value>node2:9000</value>
    </property>

    <property>
        <name>dfs.namenode.rpc-address.hdfscluster.nn3</name>
        <value>node3:9000</value>
    </property>

    <property>
        <name>dfs.namenode.http-address.hdfscluster.nn2</name>
        <value>node2:50070</value>
    </property>

    <property>
        <name>dfs.namenode.http-address.hdfscluster.nn3</name>
        <value>node3:50070</value>
    </property>

    <property>
        <name>dfs.namenode.shared.edits.dir</name>
        <value>qjournal://node1:8485;node2:8485;node3:8485/lagou</value>
    </property>

    <property>
        <name>dfs.client.failover.proxy.provider.hdfscluster</name>
        <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value>
    </property>
    <property>
        <name>dfs.ha.fencing.methods</name>
        <!-- <value>sshfence</value> -->
        <!-- <value>sshfence(root)</value> -->
        <!-- <value>shell(/bin/true)</value> -->
        <value>
            sshfence
            shell(/bin/true)
        </value>

    </property>
    <property>
        <name>dfs.ha.fencing.ssh.private-key-files</name>
        <value>/root/.ssh/id_rsa</value>
    </property>
    <property>
        <name>dfs.journalnode.edits.dir</name>
        <value>/opt/data/journalnode</value>
    </property>
    <property>
        <name>dfs.ha.automatic-failover.enabled</name>
        <value>true</value>
    </property>
</configuration>
-
-
创建、编写
slaves文件(不要有空行,行尾不要有空格)-
pwd
touch slaves

echo node1 > slaves
echo node2 >> slaves
echo node3 >> slaves
less slaves

wc slaves
-
5.2.3 MapReduce 配置
-
修改
mapred-env.sh-
nano mapred-env.sh # 指定 JDK 目录 -
export JAVA_HOME=/opt/apps/open_jdk8u41
-
-
指定 MapReduce 计算框架使用 Yarn 进行资源调度
-
cp mapred-site.xml.template mapred-site.xml nano mapred-site.xml -
<configuration>

    <!-- 指定 MR 运行在 Yarn 上 -->
    <property>
	<name>mapreduce.framework.name</name>
        <value>yarn</value>
    </property>

</configuration>
-
5.2.4 Yarn 配置
-
修改
yarn-env.sh-
nano yarn-env.sh -
# export JAVA_HOME=/home/y/libexec/jdk1.6.0/
export JAVA_HOME=/opt/apps/open_jdk8u41
-
-
修改
yarn-site.xml-
nano yarn-site.xml -
<configuration>

    <!-- 非 HA 模式,指定 YARN 的 ResourceManager 的地址 -->
    <!-- <property> -->
        <!-- <name>yarn.resourcemanager.hostname</name>	-->
        <!-- <value>node3</value>	-->
    <!-- </property> -->

    <!-- Reducer 获取数据的方式 -->
    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>

    <!-- 日志聚集功能使能 -->
    <property>
        <name>yarn.log-aggregation-enable</name>
        <value>true</value>
    </property>
    <!-- 日志保留时间设置为 28 天(单位:秒) -->
    <property>
        <name>yarn.log-aggregation.retain-seconds</name>
        <value>2419200</value>
    </property>
    <!-- 日志服务器 -->
    <property>
        <name>yarn.log.server.url</name>
        <value>http://node1:19888/jobhistory/logs</value>
    </property>

    <!-- 以下为 HA 集群配置 -->
    <property>
        <name>yarn.resourcemanager.ha.enabled</name>
        <value>true</value>
    </property>

    <property>
        <name>yarn.resourcemanager.cluster-id</name>
        <value>cluster-yarn</value>
    </property>
    <property>
        <name>yarn.resourcemanager.ha.rm-ids</name>
        <value>rm2,rm3</value>
    </property>
    <property>
        <name>yarn.resourcemanager.hostname.rm2</name>
        <value>node2</value>
    </property>
    <property>
        <name>yarn.resourcemanager.hostname.rm3</name>
        <value>node3</value>
    </property>

    <property>
        <name>yarn.resourcemanager.webapp.address.rm2</name>
        <value>node2:8088</value>
    </property>
    <property>
        <name>yarn.resourcemanager.webapp.address.rm3</name>
        <value>node3:8088</value>
    </property>

    <property>
        <name>yarn.resourcemanager.zk-address</name>
        <value>node1:2181,node2:2181,node3:2181</value>
    </property>

    <property>
        <name>yarn.resourcemanager.recovery.enabled</name>
        <value>true</value>
    </property>
    <!-- 将 RM 的状态信息储存在 ZK 集群 -->
    <property>
        <name>yarn.resourcemanager.store.class</name>
        <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
    </property>

</configuration>
-
5.2.5 设置环境变量
# 配置环境变量
echo " " >> /etc/profile
echo "# Hadoop" >> /etc/profile
echo "export HADOOP_HOME=/opt/apps/hadoop-2.10.1" >> /etc/profile
echo "export PATH=\$PATH:\$HADOOP_HOME/bin" >> /etc/profile
echo "export PATH=\$PATH:\$HADOOP_HOME/sbin" >> /etc/profile
5.2.6 同步和验证环境变量
# 同步 Hadoop目录
$CS/rsync.sh /opt/apps/hadoop-2.10.1/

# 创建文件夹
ssh node2 "mkdir -p /opt/data/hadoop && mkdir -p /opt/data/journalnode && ls /opt/data;"
ssh node3 "mkdir -p /opt/data/hadoop && mkdir -p /opt/data/journalnode && ls /opt/data;"

# 同步环境变量
$CS/rsync.sh /etc/profile


# 刷新环境变量,并验证
source /etc/profile && echo $HADOOP_HOME && hadoop version
ssh node2 "source /etc/profile && echo $HADOOP_HOME && hadoop version;"
ssh node3 "source /etc/profile && echo $HADOOP_HOME && hadoop version;"
5.3 启动和验证
5.3.1 (初次)启动 HDFS
# 先手动开启全部节点的 journalnode
ssh node1 "source /etc/profile && hadoop-daemon.sh start journalnode;"
ssh node2 "source /etc/profile && hadoop-daemon.sh start journalnode;"
ssh node3 "source /etc/profile && hadoop-daemon.sh start journalnode;"

# 先在 NN2 上执行格式化,并启动
ssh node2 "source /etc/profile && hadoop namenode -format;"
ssh node2 "source /etc/profile && hadoop-daemon.sh start namenode;"

# 在 NN3 上同步 NN2 的元数据信息
ssh node3 "source /etc/profile && hdfs namenode -bootstrapStandby;"

# 在 NN2 上初始化 ZKFC
ssh node2 "source /etc/profile && hdfs zkfc -formatZK;"

# 先关闭这几个手动单独开启的进程
ssh node2 "source /etc/profile && hadoop-daemon.sh stop namenode;"
ssh node1 "source /etc/profile && hadoop-daemon.sh stop journalnode;"
ssh node2 "source /etc/profile && hadoop-daemon.sh stop journalnode;"
ssh node3 "source /etc/profile && hadoop-daemon.sh stop journalnode;"

# 启动 hdfs 集群(不用再单独逐个启动/关停)
start-dfs.sh
	# 关闭是 stop-dfs.sh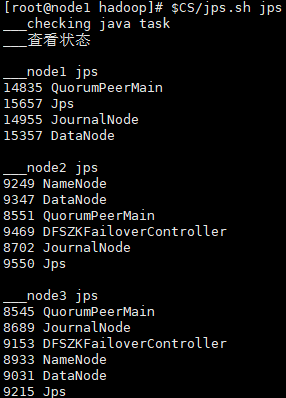
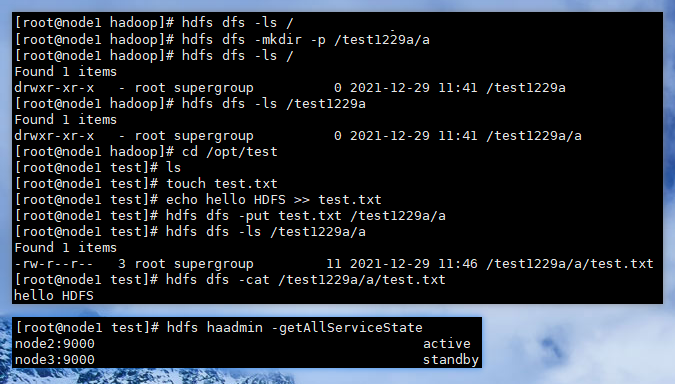
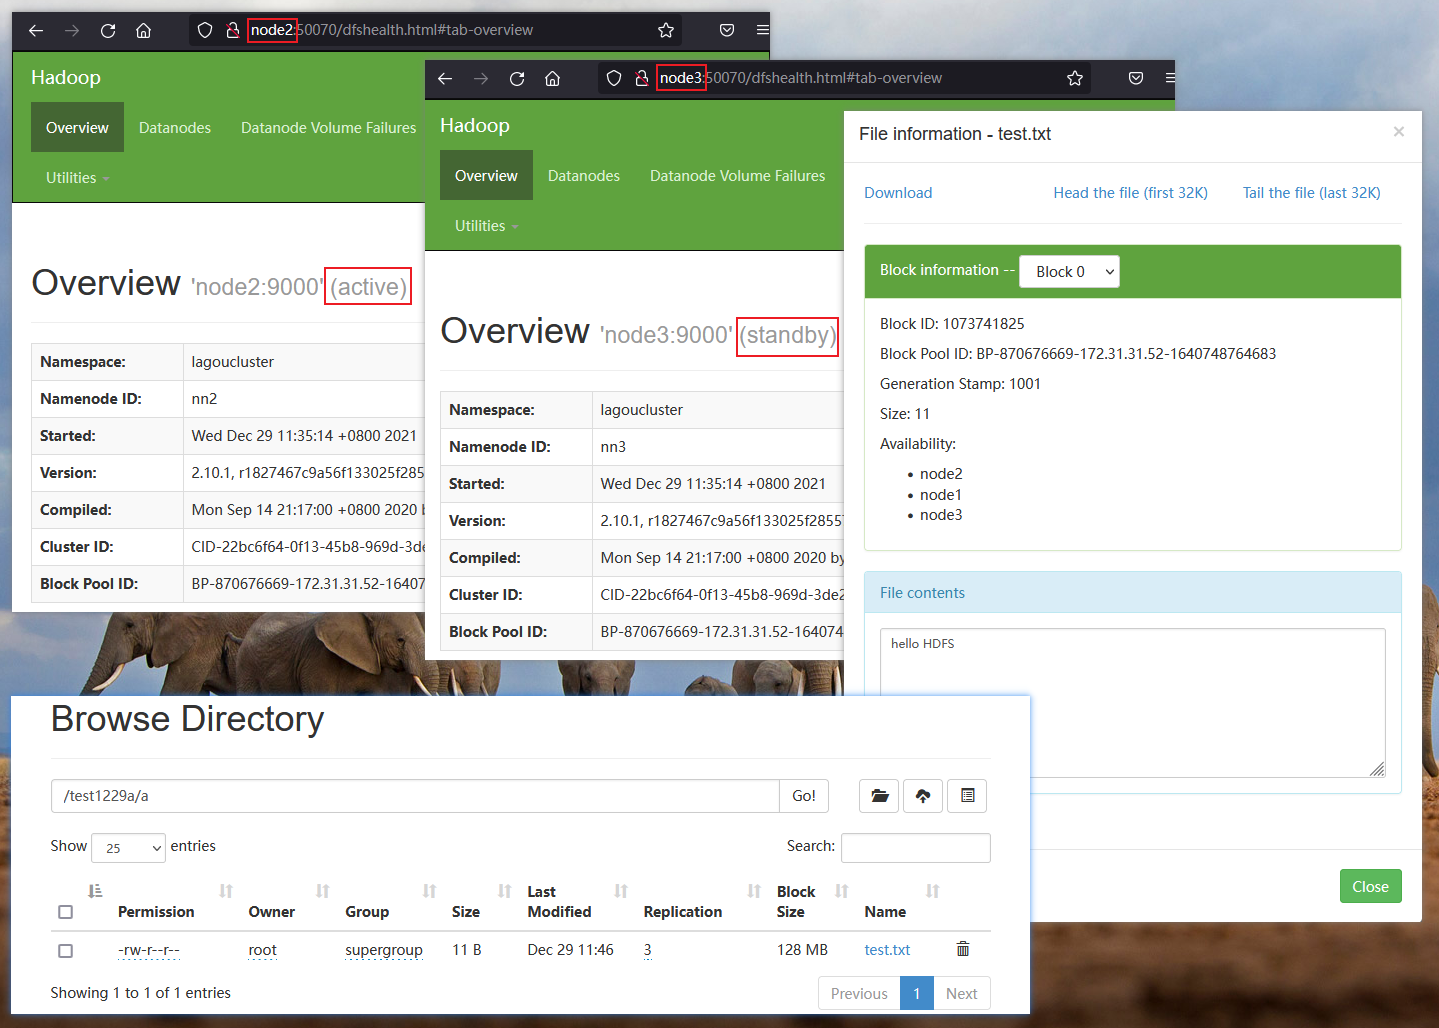
5.3.2 验证 HDFS
5.3.3 启动 YARN
# 在 node3 上启动集群
ssh node3 "source /etc/profile && start-yarn.sh;"

# 在 node2 上单独启动 resourcemanager
ssh node2 "source /etc/profile && yarn-daemon.sh start resourcemanager;"
# 在 node1 上启动 historyserver
ssh node1 "source /etc/profile && mr-jobhistory-daemon.sh start historyserver;"
关停操作(反序)
ssh node1 "source /etc/profile && mr-jobhistory-daemon.sh stop historyserver;"
ssh node2 "source /etc/profile && yarn-daemon.sh stop resourcemanager;"
ssh node3 "source /etc/profile && stop-yarn.sh;"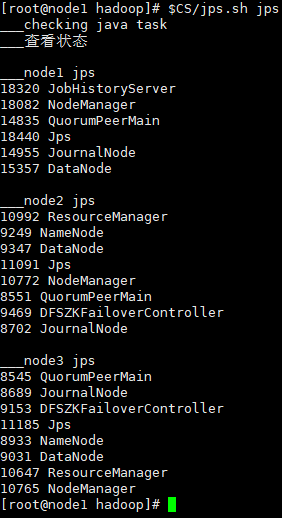
5.3.4 验证 YARN 和 MR
使用 Hadoop 内置的 wordcount 示例程序,对 《小王子》(英文版)进行计算
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.10.1.jar wordcount /test1229a/wcinput /test1229a/wcoutput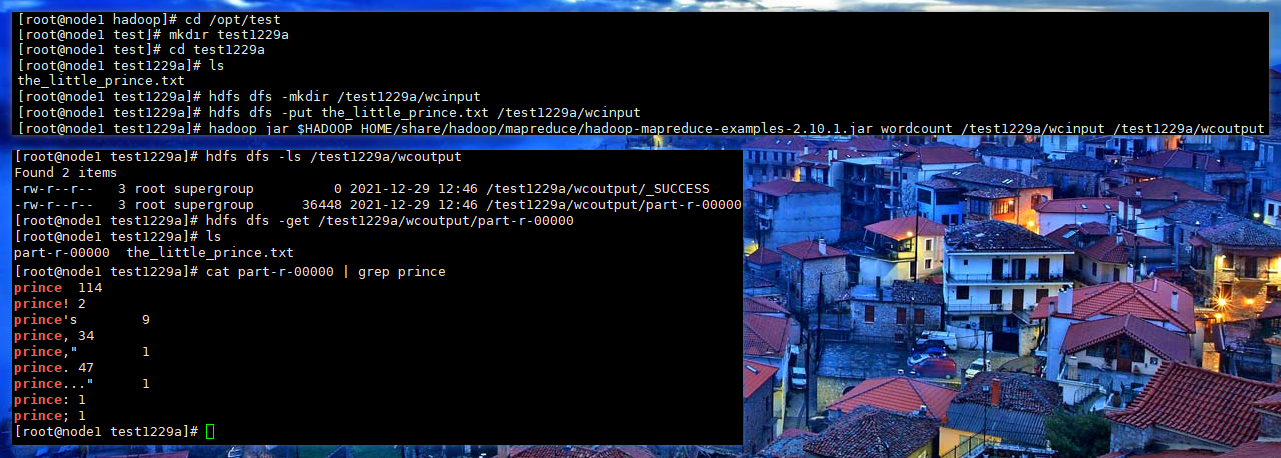
5.3.5 验证 HA 功能
hdfs haadmin -getAllServiceState
yarn rmadmin -getAllServiceState

# 查看 namenode 和 resourcemanager 的 pid
ssh node2 "source /etc/profile && jps;"

# 手动 kill 进程,模拟 namenode 和 resourcemanager 故障
ssh node2 "kill -9 21064 && sleep 10s && kill -9 20509;"

# 从下图可以看到 HA 正如预期工作,顺利切换

# 正常执行 MR 任务
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.10.1.jar wordcount /test1229a/wcinput /test1229a/wcoutput2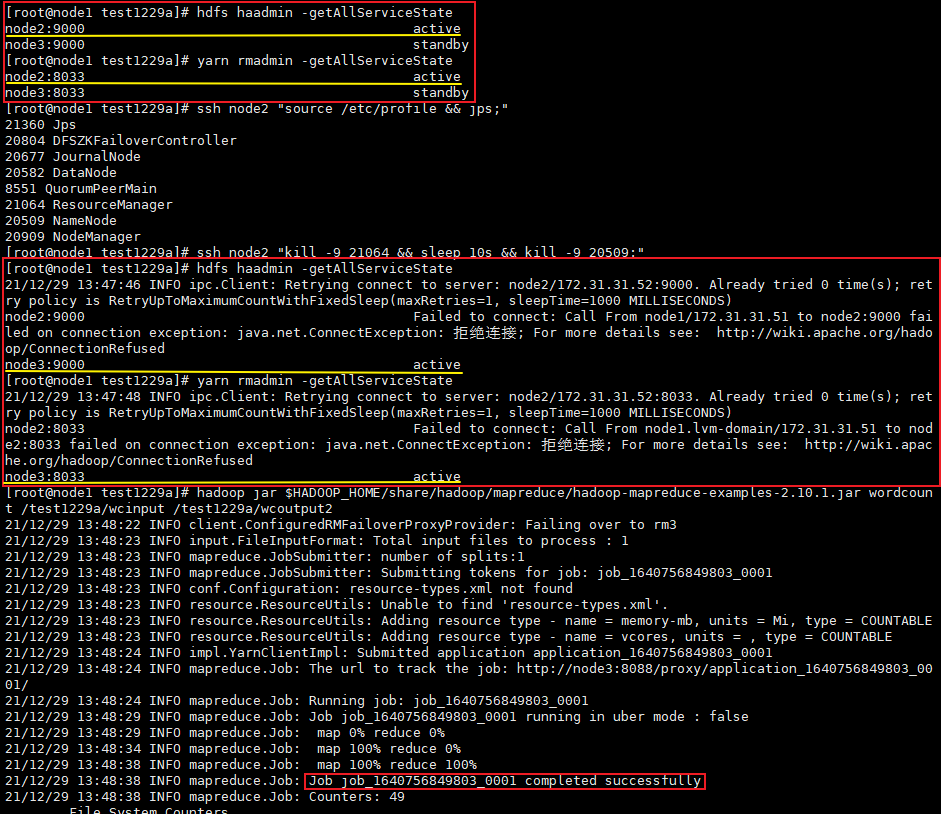
关机,快照 004
6 安装 Hive
6.1 规划
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
| »> HIVE(远程部署模式): | |||
| MetadataDB(MySQL) | ✔ | ✘ | ✘ |
| Hive Client(非常驻) | ✔ | ✔ | ✔ |
| Metastore | ✔ | ✘ | ✘ |
| HiveServer2(用到再装) | (✔) | ✘ | ✘ |
| Beeline Client(非常驻,可连H2) | (✔) | (✔) | (✔) |
| HCatalog(非常驻,不常用) | (✔) | (✔) | (✔) |
6.2 安装 MySQL
安装过程(略)
关机,快照 004a(单独这台)
6.3 建库、用户及授权
创建用于存放 Hive 元数据的库,及用于连接该库的用户,并进行授权:
-- 创建库
show databases;
create database hivemetadata;
show databases;

-- 查看密码策略
show variables like '%validate_password_policy%';
show variables like '%validate_password_length%';
-- 先把密码策略改为 LOW
set global validate_password_policy=0;
show variables like '%validate_password_policy%';

-- 创建用户、口令,授权 hive.*(hive库下的所有表),刷新
CREATE USER 'hive'@'%' IDENTIFIED BY '12345678';
GRANT ALL ON hivemetadata .* TO 'hive'@'%';
FLUSH PRIVILEGES;

-- 再把密码策略改回来
set global validate_password_policy=2;
show variables like '%validate_password_policy%';
6.4 安装 HIVE
6.4.1 下载解压
# 下载(略)

cd /opt/software/
ls
tar -zxvf apache-hive-2.3.9-bin.tar.gz
ls
mv apache-hive-2.3.9-bin /opt/apps/hive-2.3.9
ls
ls /opt/apps/
6.4.2 上传 jdbc 驱动文件、删除重复的 log4j
ls /opt/apps/hive-2.3.9/lib/ | grep mysql
cp /opt/software/mysql-connector-java-5.1.49-bin.jar /opt/apps/hive-2.3.9/lib/
ls /opt/apps/hive-2.3.9/lib/ | grep mysql


ls /opt/apps/hive-2.3.9/lib/ | grep slf4j
mv /opt/apps/hive-2.3.9/lib/log4j-slf4j-impl-2.6.2.jar \
/opt/apps/hive-2.3.9/lib/log4j-slf4j-impl-2.6.2.jar.bak
ls /opt/apps/hive-2.3.9/lib/ | grep slf4j
6.4.3 修改 Hive 日志输出目录
-
默认的日志文件存放在:
/tmp/<当前用户名> -
mkdir -p /opt/logs/hive cd /opt/apps/hive-2.3.9/conf/ ls cp hive-log4j2.properties.template hive-log4j2.properties ls nano hive-log4j2.properties # 修改下面这行 -
修改这行:
-
#property.hive.log.dir = ${sys:java.io.tmpdir}/${sys:user.name}
property.hive.log.dir = /opt/logs/hive
-
6.4.4 创建、编写 hive-site.xml 配置文件
-
nano /opt/apps/hive-2.3.9/conf/hive-site.xml -
<?xml version="1.0" encoding="UTF-8" standalone="no"?> <?xml-stylesheet type="text/xsl" href="configuration.xsl"?> <configuration> <!-- 操作小规模数据时,使用本地模式,提高效率 --> <property> <name>hive.exec.mode.local.auto</name> <value>true</value> <description>Let Hive determine whether to run in local mode automatically</description> </property> <!-- hive 元数据的数据库连接 --> <!-- hive 元数据的存储位置 --> <property> <name>javax.jdo.option.ConnectionURL</name> <value>jdbc:mysql://node1:3306/hivemetadata?useUnicode=true&characterEncoding=utf8&useSSL=false</value> <description>JDBC connect string for a JDBC metastore</description> </property> <!-- 指定驱动程序 --> <property> <name>javax.jdo.option.ConnectionDriverName</name> <value>com.mysql.jdbc.Driver</value> <description>Driver class name for a JDBC metastore</description> </property> <!-- 连接数据库的用户名 --> <property> <name>javax.jdo.option.ConnectionUserName</name> <value>hive</value> <description>username to use against metastore database</description> </property> <!-- 连接数据库的口令 --> <property> <name>javax.jdo.option.ConnectionPassword</name> <value>12345678</value> <description>password to use against metastore database</description> </property> <!-- HIVE 数据默认的存储位置(HDFS) --> <property> <name>hive.metastore.warehouse.dir</name> <value>/user/hive/warehouse</value> <description>location of default database for the warehouse</description> </property> <!-- 在 Hive CLI 中,显示当前操作的数据库 --> <property> <name>hive.cli.print.current.db</name> <value>true</value> <description>Whether to include the current database in the Hive prompt.</description> </property> <!-- 在 Hive CLI 中,显示数据的表头 --> <property> <name>hive.cli.print.header</name> <value>true</value> </property> </configuration> -
# 同步到其他主机
$CS/rsync.sh /opt/apps/hive-2.3.9
6.4.5 设置环境变量
# 配置环境变量
echo " " >> /etc/profile
echo "# Hive" >> /etc/profile
echo "export HIVE_HOME=/opt/apps/hive-2.3.9" >> /etc/profile
echo "export PATH=\$PATH:\$HIVE_HOME/bin" >> /etc/profile

# 同步环境变量
$CS/rsync.sh /etc/profile

# 刷新环境变量,并验证
source /etc/profile && echo $HIVE_HOME && hive --version
ssh node2 "source /etc/profile && echo $HIVE_HOME && hive --version;"
ssh node3 "source /etc/profile && echo $HIVE_HOME && hive --version;"
6.5 初始化及验证(本地模式)
-
初始化元数据库
-
schematool -dbType mysql -initSchema -
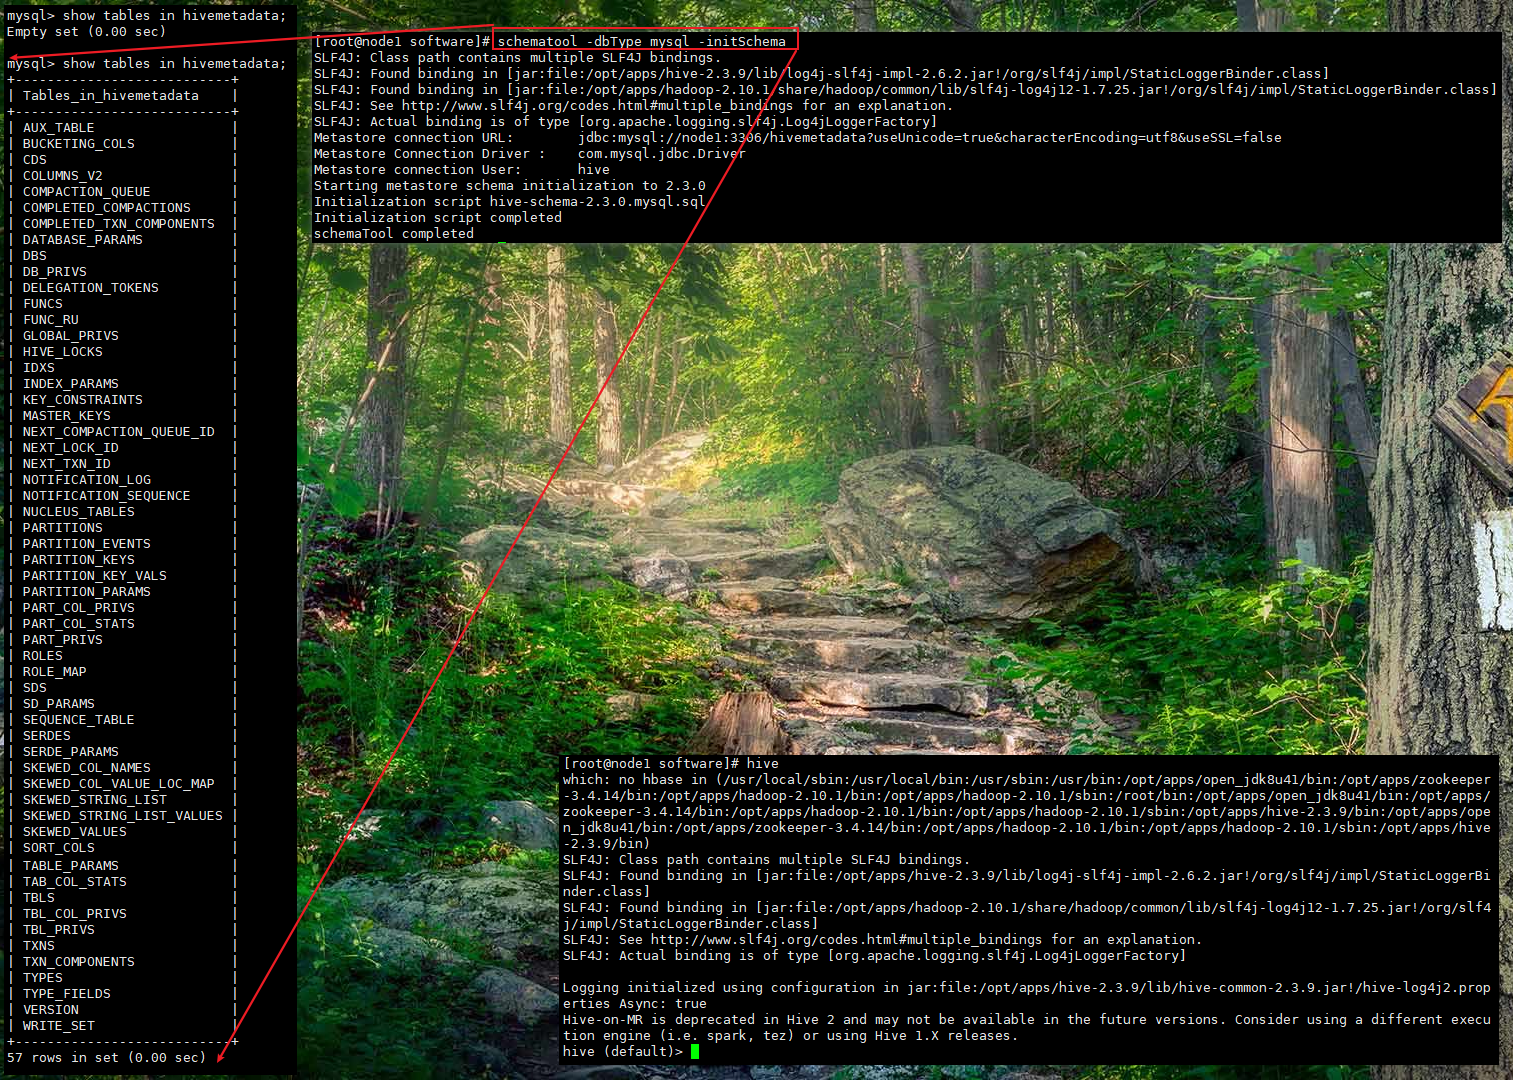
013
-
-
测试
-
create table test.test1(
id int,
name string
);

select * from test.test1;

insert into test.test1 values
(1001,'adam'),
(1002,'ben');

select * from test.test1;
-
6.6 配置 “远程模式部署”
6.6.1 给 hive metastore 服务单独创建一份配置文件
-
mkdir -p /opt/conf/hive_metastore_conf mkdir -p /opt/logs/hive/metastore cp /opt/apps/hive-2.3.9/conf/hive-site.xml /opt/conf/hive_metastore_conf/hive-site.xml cp /opt/apps/hive-2.3.9/conf/hive-log4j2.properties /opt/conf/hive_metastore_conf/hive-log4j2.properties nano /opt/conf/hive_metastore_conf/hive-site.xml nano /opt/conf/hive_metastore_conf/hive-log4j2.properties -
hive-site.xml只保留 “连接存储元数据的数据库” 部分-
<!-- hive 元数据的数据库连接 --> <!-- hive 元数据的存储位置 --> <property> <name>javax.jdo.option.ConnectionURL</name> <value>jdbc:mysql://node1:3306/hivemetadata?useUnicode=true&characterEncoding=utf8&useSSL=false</value> <description>JDBC connect string for a JDBC metastore</description> </property> <!-- 指定驱动程序 --> <property> <name>javax.jdo.option.ConnectionDriverName</name> <value>com.mysql.jdbc.Driver</value> <description>Driver class name for a JDBC metastore</description> </property> <!-- 连接数据库的用户名 --> <property> <name>javax.jdo.option.ConnectionUserName</name> <value>hive</value> <description>username to use against metastore database</description> </property> <!-- 连接数据库的口令 --> <property> <name>javax.jdo.option.ConnectionPassword</name> <value>12345678</value> <description>password to use against metastore database</description> </property>
-
-
hive-log4j2.properties另外指定一下日志输出目录-
#property.hive.log.dir = ${sys:java.io.tmpdir}/${sys:user.name}
property.hive.log.dir = /opt/logs/hive/metastore
-
6.6.2 修改 Hive 客户端的配置文件(默认路径里的配置文件)
-
nano /opt/apps/hive-2.3.9/conf/hive-site.xml -
去掉 “连接存储元数据的数据库” 部分,替换为连接 metastore 服务的设置
-
    <!-- hive metastore 服务地址 -->
    <property>
        <name>hive.metastore.uris</name>
        <!-- <value>thrift://node2:9083,thrift://node3:9083</value> -->
        <value>thrift://node1:9083</value>
    </property>
-
-
同步到其他节点
-
$CS/rsync.sh /opt/apps/hive-2.3.9/conf/hive-site.xml
-
6.7 启动和验证(远程模式)
-
启动 zookeeper 、hadoop(略)
-
启动 hive metastore 服务
-
hive --config /opt/conf/hive_metastore_conf/ --service metastore -
该进程占用终端(可使用
nohup或screen实现后台运行)
-
-
分别在 node1 、node2 、node3 上启动 hive 并执行操作
-
create table test.test10(
id int,
name string
);

select * from test.test10;

insert into test.test10 values
(1001,'adam'),
(1002,'ben');

select * from test.test10;

-- 改表名执行
-
-
查看连接

014 - 可以看到,3 个客户端 连接了 hive metastore 的 9083 端口
关机,快照 005
7 安装 Tez
7.1 规划
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
| »> Tez(无后台服务): | ✔ | ✔ | ✔ |
7.2 安装
7.2.1 下载解压
# 下载(略)

cd /opt/software/
ls
tar -zxvf apache-tez-0.9.2-bin.tar.gz
ls
mv apache-tez-0.9.2-bin /opt/apps/tez-0.9.2
ls
ls /opt/apps/
7.2.2 上传 tez.tar.gz 到 hdfs 上
cd /opt/apps/tez-0.9.2/share/
hdfs dfs -mkdir /user/tez/
hdfs dfs -put tez.tar.gz /user/tez/
hdfs dfs -ls /user/tez/
7.2.3 创建、编写 tez-site.xml 配置文件
-
ls $HADOOP_HOME/etc/hadoop/ touch $HADOOP_HOME/etc/hadoop/tez-site.xml nano $HADOOP_HOME/etc/hadoop/tez-site.xml -
写入如下内容:
-
<?xml version="1.0" encoding="UTF-8" standalone="no"?>
<?xml-stylesheet type="text/xsl" href="configuration.xsl"?>

<configuration>
    <!-- 指定在 hdfs 上的 tez 包文件 -->
    <property>
        <name>tez.lib.uris</name>
        <value>hdfs://hdfscluster/user/tez/tez.tar.gz</value>
    </property>
</configuration>
-
7.2.4 删除重复的 log4j
ls /opt/apps/tez-0.9.2/lib/ | grep slf4j
mv /opt/apps/tez-0.9.2/lib/slf4j-log4j12-1.7.10.jar /opt/apps/tez-0.9.2/lib/slf4j-log4j12-1.7.10.jar.bak
ls /opt/apps/tez-0.9.2/lib/ | grep slf4j
7.2.5 设置环境变量
echo " " >> /etc/profile
echo "# Tez" >> /etc/profile
echo "export TEZ_CONF_DIR=\$HADOOP_HOME/etc/hadoop" >> /etc/profile
echo "export TEZ_JARS=/opt/apps/tez-0.9.2/*:/opt/apps/tez-0.9.2/lib/*" >> /etc/profile
echo "export HADOOP_CLASSPATH=\$TEZ_CONF_DIR:\$TEZ_JARS:\$HADOOP_CLASSPATH" >> /etc/profile
7.2.6 同步及验证环境变量
$CS/rsync.sh $HADOOP_HOME/etc/hadoop/tez-site.xml
$CS/rsync.sh /opt/apps/tez-0.9.2/

source /etc/profile && echo $TEZ_CONF_DIR; echo $HADOOP_CLASSPATH;

$CS/rsync.sh /etc/profile
ssh node2 "source /etc/profile && echo $TEZ_CONF_DIR; echo $HADOOP_CLASSPATH;"
ssh node3 "source /etc/profile && echo $TEZ_CONF_DIR; echo $HADOOP_CLASSPATH;"
7.3 验证
(配置完 Tez 后,需要重启集群)
7.3.1 验证 Hive on Tez
-
-- 查看、设置 Hive 的执行引擎(只对本会话有效) set hive.execution.engine; set hive.execution.engine=tez; set hive.execution.engine; -- 关闭 “对小任务自动使用本地模式执行” set hive.exec.mode.local.auto=false; -- 执行 union all 查询 select * from test.test1 union all select * from test.test2; -
测试的时候遇到了
AM Container is running beyond virtual memory limits的错误-
解决方法:修改
yarn-site.xml配置文件,将虚拟内存比例调大到 5 ,默认是 2.1,参考 -
nano $HADOOP_HOME/etc/hadoop/yarn-site.xml # 添加下面的属性 -
    <property>
        <name>yarn.nodemanager.vmem-pmem-ratio</name>
        <value>5</value>
        <description>Ratio between virtual memory to physical memory when setting memory limits for containers. Container allocations are expressed in terms of physical memory, and virtual memory usage is allowed to exceed this allocation by this ratio.</description>
    </property>
-
-
再次重启集群、测试
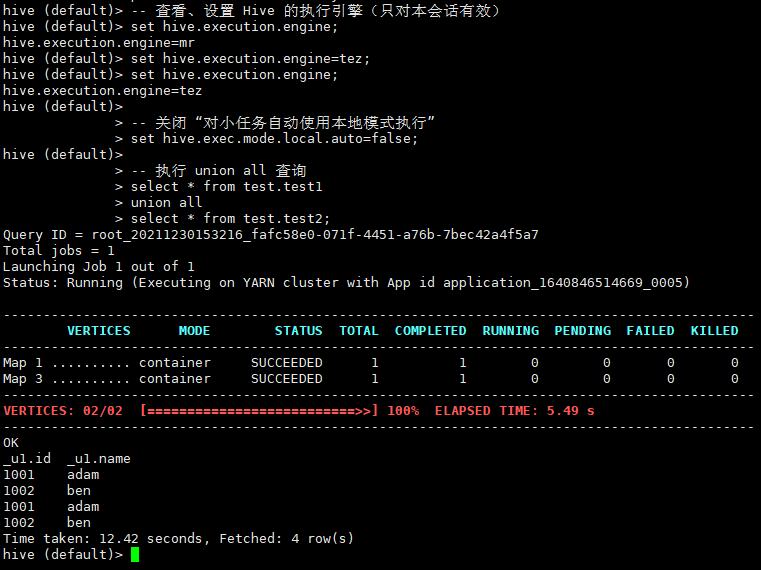
015
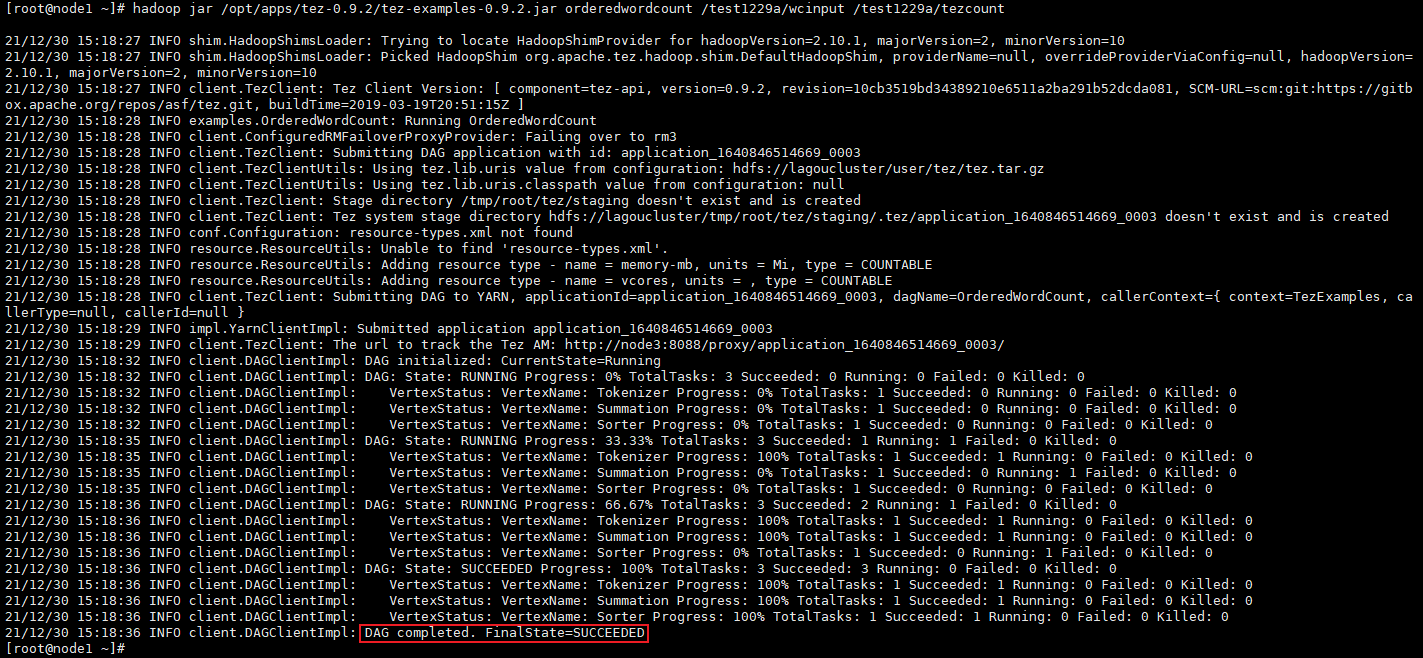
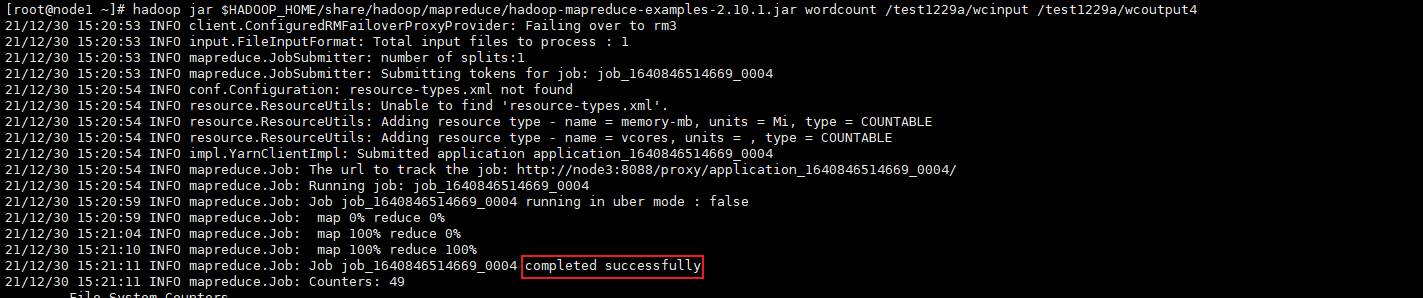
7.3.2 验证 wordcount 程序
# Tez wordcount
hadoop jar /opt/apps/tez-0.9.2/tez-examples-0.9.2.jar orderedwordcount /test1229a/wcinput /test1229a/tezcount1

# MapReduce wordcount
hadoop jar $HADOOP_HOME/share/hadoop/mapreduce/hadoop-mapreduce-examples-2.10.1.jar wordcount /test1229a/wcinput /test1229a/wcoutput1
Tez wordcount:
MapReduce wordcount:
关机,快照 006
8 安装 Flume
8.1 规划
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
| »> Flume(无后台服务): | ✔ | ✔ | ✔ |
8.2 安装
8.2.1 下载解压
cd /opt/software
ls
tar -zxvf apache-flume-1.9.0-bin.tar.gz
ls
mv apache-flume-1.9.0-bin /opt/apps/flume-1.9.0
ls
ls /opt/apps
8.2.2 修改 flume-env.sh 配置文件
cd /opt/apps/flume-1.9.0/conf
ls
cp flume-env.sh.template flume-env.sh
nano flume-env.sh
# 添加 JAVA_HOME,如下
指定 JDK 环境变量:
# export JAVA_HOME=/usr/lib/jvm/java-8-oracle
export JAVA_HOME=/opt/apps/open_jdk8u41
8.2.3 修改 log4j.properties 配置文件
mkdir -p /opt/logs/flume
nano /opt/apps/flume-1.9.0/conf/log4j.properties
指定日志输出的目录:
#flume.log.dir=./logs
flume.log.dir=/opt/logs/flume
8.2.4 设置环境变量
echo " " >> /etc/profile
echo "# Flume" >> /etc/profile
echo "export FLUME_HOME=/opt/apps/flume-1.9.0" >> /etc/profile
echo "export PATH=\$PATH:\$FLUME_HOME/bin" >> /etc/profile
8.2.5 同步及验证环境变量
$CS/rsync.sh /opt/apps/flume-1.9.0
$CS/rsync.sh /etc/profile

source /etc/profile && echo $FLUME_HOME; flume-ng version;
ssh node2 "source /etc/profile && echo $FLUME_HOME; flume-ng version;"
ssh node3 "source /etc/profile && echo $FLUME_HOME; flume-ng version;"
8.3 验证
-
编写一个最简单的 Agent 配置文件
-
mkdir -p /opt/conf/flume_agents cd /opt/conf/flume_agents/ nano flume_demo_netcat_logger.conf -
# a1是agent的名称。source、channel、sink的名称分别为:r1 c1 k1
a1.sources = r1
a1.channels = c1
a1.sinks = k1

# source
a1.sources.r1.type = netcat
a1.sources.r1.bind = node1
a1.sources.r1.port = 54321

# channel
a1.channels.c1.type = memory

# sink
a1.sinks.k1.type = logger

# source、channel、sink之间的关系
a1.sources.r1.channels = c1
a1.sinks.k1.channel = c1
-
-
启动 Agent
-
flume-ng agent --name a1 \ --conf-file /opt/conf/flume_agents/flume_demo_netcat_logger.conf \ -Dflume.root.logger=INFO,console -
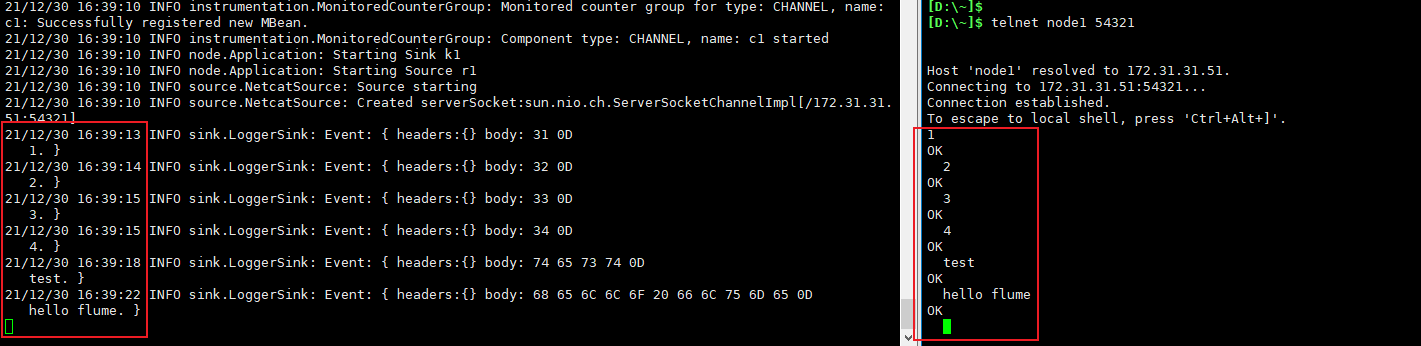
018
-
关机,快照 007
9 安装 DataX
9.1 规划
| 虚拟机 | Cluster_Node1 | Cluster_Node2 | Cluster_Node3 |
|---|---|---|---|
| 整体规划 | 单独安装的应用 + 全部安装的应用 |
HA1 + 全部安装的应用 |
HA2 + 全部安装的应用 |
| »> DataX(无后台服务): | ✔ | ✔ | ✔ |
9.2 安装
9.2.1 下载解压
cd /opt/software/
ls
tar -zxvf datax.tar.gz
ls
可能是发布方用苹果电脑打包的时候不注意,每个目录都多了个 ._<目录名> 的伴随文件,这会导致使用的时候报类似 datax/plugin/reader/._drdsreader/plugin.json]不存在 的错误。
把这些 ._<目录名> 文件删除就好:
du -ach --max-depth=1 datax
tree datax/plugin/ -L 2
find ./datax -type f -name "._*" | xargs rm -f
du -ach --max-depth=1 datax
tree datax/plugin/ -L 2
移动到 /opt/apps 目录
mv datax /opt/apps/
ls
ls /opt/apps/
9.2.2 设置环境变量
echo " " >> /etc/profile
echo "# DataX" >> /etc/profile
echo "export DATAX_HOME=/opt/apps/datax" >> /etc/profile
9.2.3 同步及验证环境变量
$CS/rsync.sh /opt/apps/datax
$CS/rsync.sh /etc/profile

source /etc/profile && echo $DATAX_HOME;
ssh node2 "source /etc/profile && echo $DATAX_HOME;"
ssh node3 "source /etc/profile && echo $DATAX_HOME;"
9.3 验证
使用 DataX 预设的一个用于自检的 job 配置进行验证:
python $DATAX_HOME/bin/datax.py $DATAX_HOME/job/job.json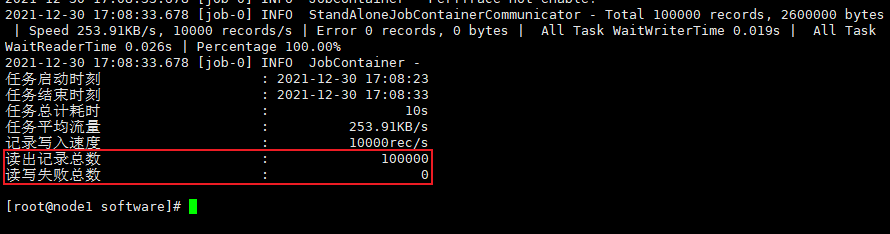
关机,快照 008
10 附录:脚本
10.1 all.sh
#!/bin/sh
# all.sh

hosts="node1 node2 node3";
date=$(date "+%Y%m%d")
#echo ${date}

# stat0,简单状态查看
function stat0(){
    for host in $hosts
    do
      	echo -e "\n___${host}_基本状态";
        ssh $host "source /etc/profile && \
            $ZK_HOME/bin/zkServer.sh status; \
            echo ' '; jps;";
    done
    exit;
}

# stat1,更多状态查看
function stat1(){
    echo -e "\nNameNode-HA status:";
    hdfs haadmin -getAllServiceState;
    echo -e "\nResourceManager-HA status:";
    yarn rmadmin -getAllServiceState;

    stat0;
    exit;
}

# start,启动
function start(){
    echo "___启动集群";

    # 启动 zookeeper
    for host in $hosts
    do
        ssh $host "source /etc/profile && $ZK_HOME/bin/zkServer.sh start";
    done
    sleep 5s;

    # 启动 Hadoop
    ssh node1 "source /etc/profile && $HADOOP_HOME/sbin/start-dfs.sh";
    ssh node3 "source /etc/profile && $HADOOP_HOME/sbin/start-yarn.sh";
    ssh node2 "source /etc/profile && $HADOOP_HOME/sbin/yarn-daemon.sh start resourcemanager;";
    ssh node1 "source /etc/profile && $HADOOP_HOME/sbin/mr-jobhistory-daemon.sh start historyserver";

    # 启动 Hive MetaStore 服务
    ssh node1 "source /etc/profile && \
        screen -dmS hmeta && \
        sleep 5s ; \
        screen -S hmeta -X stuff '$HIVE_HOME/bin/hive --config /opt/conf/hive_metastore_conf/ --service metastore >> /opt/logs/hive/metastore/hmeta_out_${date} ^M'";

    stat1;
    exit;
}

# stop,关停
function stop(){
    echo "___关闭集群";

    # 关闭 Hive MetaStore 服务
    ssh node1 "screen -S hmeta -X stuff '^C'; sleep 5s; screen -X -S hmeta quit";

    # 关闭 Hadoop
    ssh node1 "source /etc/profile && mr-jobhistory-daemon.sh stop historyserver;"
    ssh node2 "source /etc/profile && $HADOOP_HOME/sbin/yarn-daemon.sh stop resourcemanager";
    sleep 5s;
    ssh node3 "source /etc/profile && $HADOOP_HOME/sbin/stop-yarn.sh";
    sleep 5s;
    ssh node1 "source /etc/profile; $HADOOP_HOME/sbin/stop-dfs.sh";
    sleep 5s;

    # 关闭 ZooKeeper
    for host in $hosts
    do
      	ssh $host "source /etc/profile && $ZK_HOME/bin/zkServer.sh stop";
    done

    stat0;
    exit;
}


if(($#!=1));then
    echo "___params count error";
    exit;
elif [ "$1" == 'stat0' ];then
    stat0;
    exit;
elif [ "$1" == 'stat1' ];then
    stat1;
    exit;
elif [ "$1" == 'start' ];then
    start;
    exit;
elif [ "$1" == 'stop' ];then
    stop;
    exit;
else
    echo "___wrong param";
    exit;
fi

exit;
10.2 rsync.sh
#!/bin/bash
# rsync.sh

# 获取命令输入参数的个数,如果个数不为 1 ,报错退出
paramnum=$#
if(($paramnum != 1)); then
	echo $paramnum;
	echo params count error;
	exit;
fi

# 获取参数
p1=$1
echo $p1

# 获取输入参数的所在路径(上一级路径)
# pdir=`dirname $p1`
# 上面的方式存在问题:如果 $p1 是绝对路径,能正常返回“上一级目录”;如果是相对路径,则返回“.”
pdir=`cd -P $(dirname $p1); pwd`
echo pdir=$pdir

# 根据传入参数获取文件名称
file_name=`basename $p1`
echo fname=$file_name


# 获取用户名称
user=`whoami`

#exit;

# 循环执行 rsync
# 从 node2 开始
for((host=2; host<4; host++)); do
	echo ------------------- centos7-$host --------------
	rsync -rvl $pdir/$file_name $user@node$host:$pdir
done
10.3 poweroff.sh
#!/bin/sh
# poweroff.sh

echo "___shutting down clusters"

hosts="node2 node3"

for host in $hosts
do
	echo "___${host}";
	ssh $host "poweroff";
    sleep 5s ;
done

poweroff;
10.4 reboot.sh
#!/bin/sh
# reboot.sh

echo "___rebooting clusters"

hosts="node2 node3"

for host in $hosts
do
	echo "___${host}";
	ssh $host "reboot";
    sleep 5s ;
done

reboot;
10.5 du.sh
#!/bin/sh
# du.sh

echo "___checking disk usage"

hosts="node1 node2 node3"

for host in $hosts
do
	echo "___${host}";
	ssh $host "df -hT";
done