
MySQL笔记_1_基础_1
MySQL笔记_1_基础_1
1 MySQL 基础知识
结构化查询语言(Structured Query Language)简称 SQL ,是一种特殊目的的编程语言,是一种数据库查询和程序设计语言,用于存取数据以及查询、更新和管理关系数据库系统。
用于管理关系数据库管理系统(RDBMS),或在关系流数据管理系统(RDSMS)中进行流处理。
SQL 基于关系代数和元组关系演算,包括数据定义语言和数据操纵语言。SQL 包括数据插入、查询、更新和删除,数据库模式创建和修改,以及数据访问控制。尽管 SQL 经常被描述为,而且很大程度上是一种声明式编程(4GL),但是其也含有过程式编程的元素。
SQL 在 1986 年成为美国国家标准学会(ANSI)的一项标准,在 1987 年成为国际标准化组织(ISO)标准。此后,这一标准经过了一系列的增订,加入了大量新特性。虽然有这一标准的存在,但大部分的 SQL 代码在不同的数据库系统中并不具有完全的跨平台性。
1.1 常见的数据库
-
MySql数据库
- 因免费开源、运作简单的特点,常作为中小型项目的数据库首选
- MySQL 始于 1996 年,08 年被 SUN 收购,09 年 SUN 被 Oracle 收购(从此,甲骨文拥有全球第一第二两款数据库软件)。
- 从版本 6 开始,甲骨文开始对MySQL收费(但同时发行免费的社区版)
-
MariaDB
- CentOS 的默认数据库
- 始于 09 年,MySQL 被收购后,业界当心其开源前景,开发了 MariaDB
- 乌尔夫·米卡埃尔·维德纽斯(瑞典语:Ulf Michael Widenius,1962年3月3日-),常昵称作蒙提(Monty),芬兰程序员与企业家,开放源代码数据库 MySQL 的主要设计者,同时也是MySQL AB公司的创始成员和现任MariaDB的首席技术官。
- MariaDB 是以 Monty 的小女儿 Maria 命名的,而 MySQL 是以他另一个女儿 My 命名的。
-
PostgreSQL
- 另一款开源免费的数据库,相比 MySQL ,提供更多大型数据库所需的功能
-
SQLite
- 与许多其它数据库管理系统不同,SQLite 不是一个客户端/服务器结构的数据库引擎,而是被集成在用户程序中。
- 它作为嵌入式数据库,是应用程序(如网页浏览器)在本地/客户端存储数据的常见选择。它可能是最广泛部署的数据库引擎,因为它正在被一些流行的浏览器、操作系统、嵌入式系统所使用。
-
MS SQL Server
- 微软的商业数据库
- 只能运行在 windows 平台上
-
Oracle 数据库
- 收费的大型数据库,Oracle 公司的核心产品。
- 安全性高,性能强,功能多
-
DB2
- IBM 的商业数据库,支持超大型数据库
- 常在银行系统中使用
-
mongoDB
- 非关系型数据库
1.2 db-engines.com 数据库排行(2021年5月)
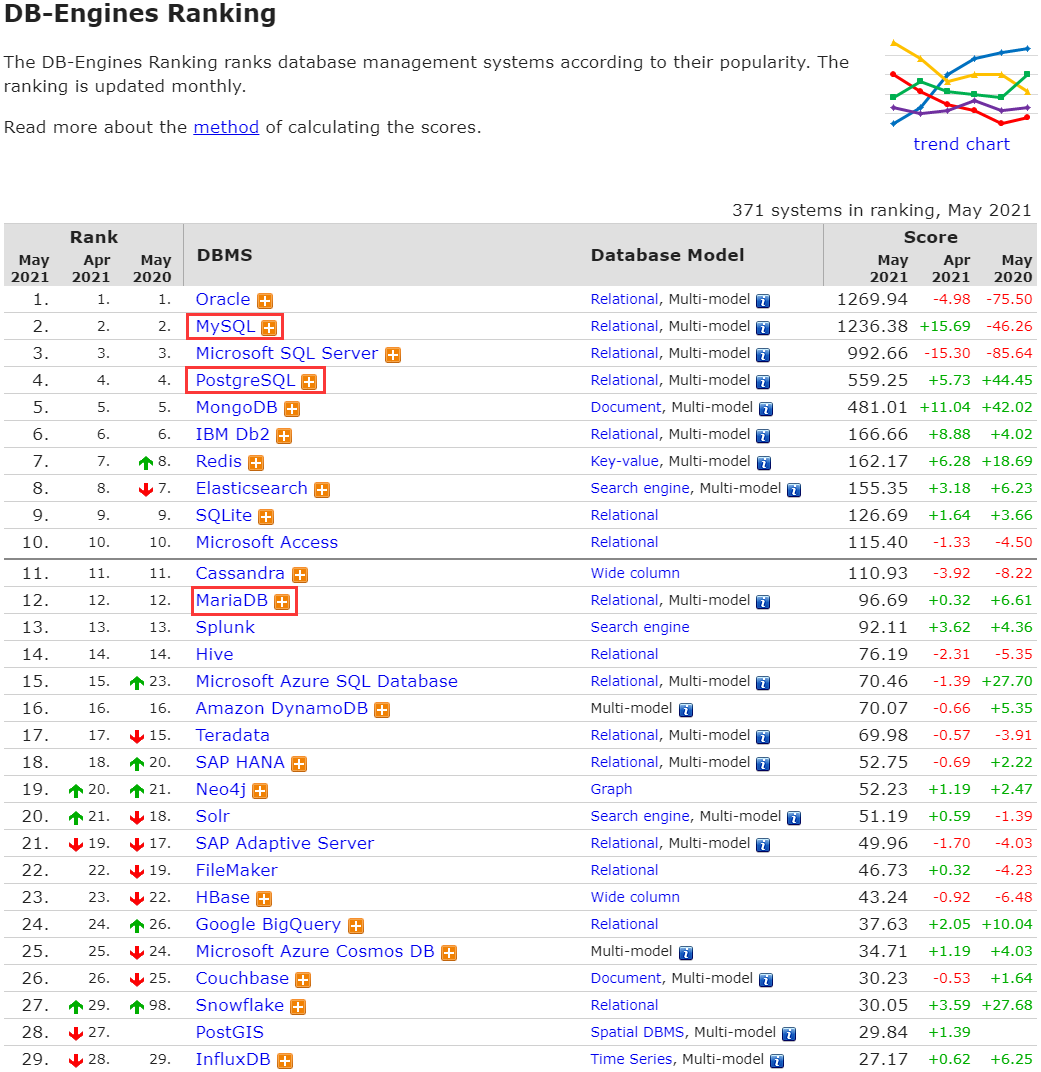
1.数据库排行)
1.3 MySql 的目录结构(以 Windows 下为例)
1.3.1 MySql的默认安装目录
C:\Program Files\MySQL\MySQL Server 5.7,其中:
bin目录- 该目录配置环境变量后,可以使用
mysql命令 - 放置一些可执行文件
- 该目录配置环境变量后,可以使用
docs目录- 文档
include目录- 包含(头)文件
lib目录- 依赖库
share目录- 用于存放字符集、语言等信息。
1.3.2 MySQL配置文件与数据存放目录
C:\ProgramData\MySQL\MySQL Server 5.7
my.ini文件- 配置文件
Data目录- 最重要:存放数据库、表,数据目录
2 SQL 语句
SQL 语句
- 是所有关系型数据库的统一查询规范,不同的关系型数据库都支持 SQL
- 所有的关系型数据库都可以使用 SQL
- 不同数据库之间的 SQL ,可能存在一些区别,类似方言
2.1 SQL 通用语法
-
SQL 语句可以 “单行” 或 “多行” 书写,以
;结尾 (Sqlyog 会自动添加分号) -
可以使用空格和缩进来增加语句的可读性
-
MySql 中使用的 SQL 不区分大小写,一般关键字大写,数据库名、表名、列名小写
-
注释方式
-
# show databases; 单行注释
-- show databases; 单行注释(-- 后面必须要有空格)
/*
多行注释
show databases;
*/
-
2.2 SQL 语句的分类
| 分类 | 说明 |
|---|---|
| 数据定义语言 DDL (Data Definition Language) |
用来定义数据库对象:数据库,表,列等 |
| 数据操作语言 DML (Data Manipulation Language) |
用来对数据库中表的记录进行更新 |
| 数据查询语言 DQL (Data Query Language) |
用来查询数据库中表的记录 |
| 数据控制语言 DCL (Date Control Language) |
用来控制数据库的访问权限和安全级别,及创建用户 |
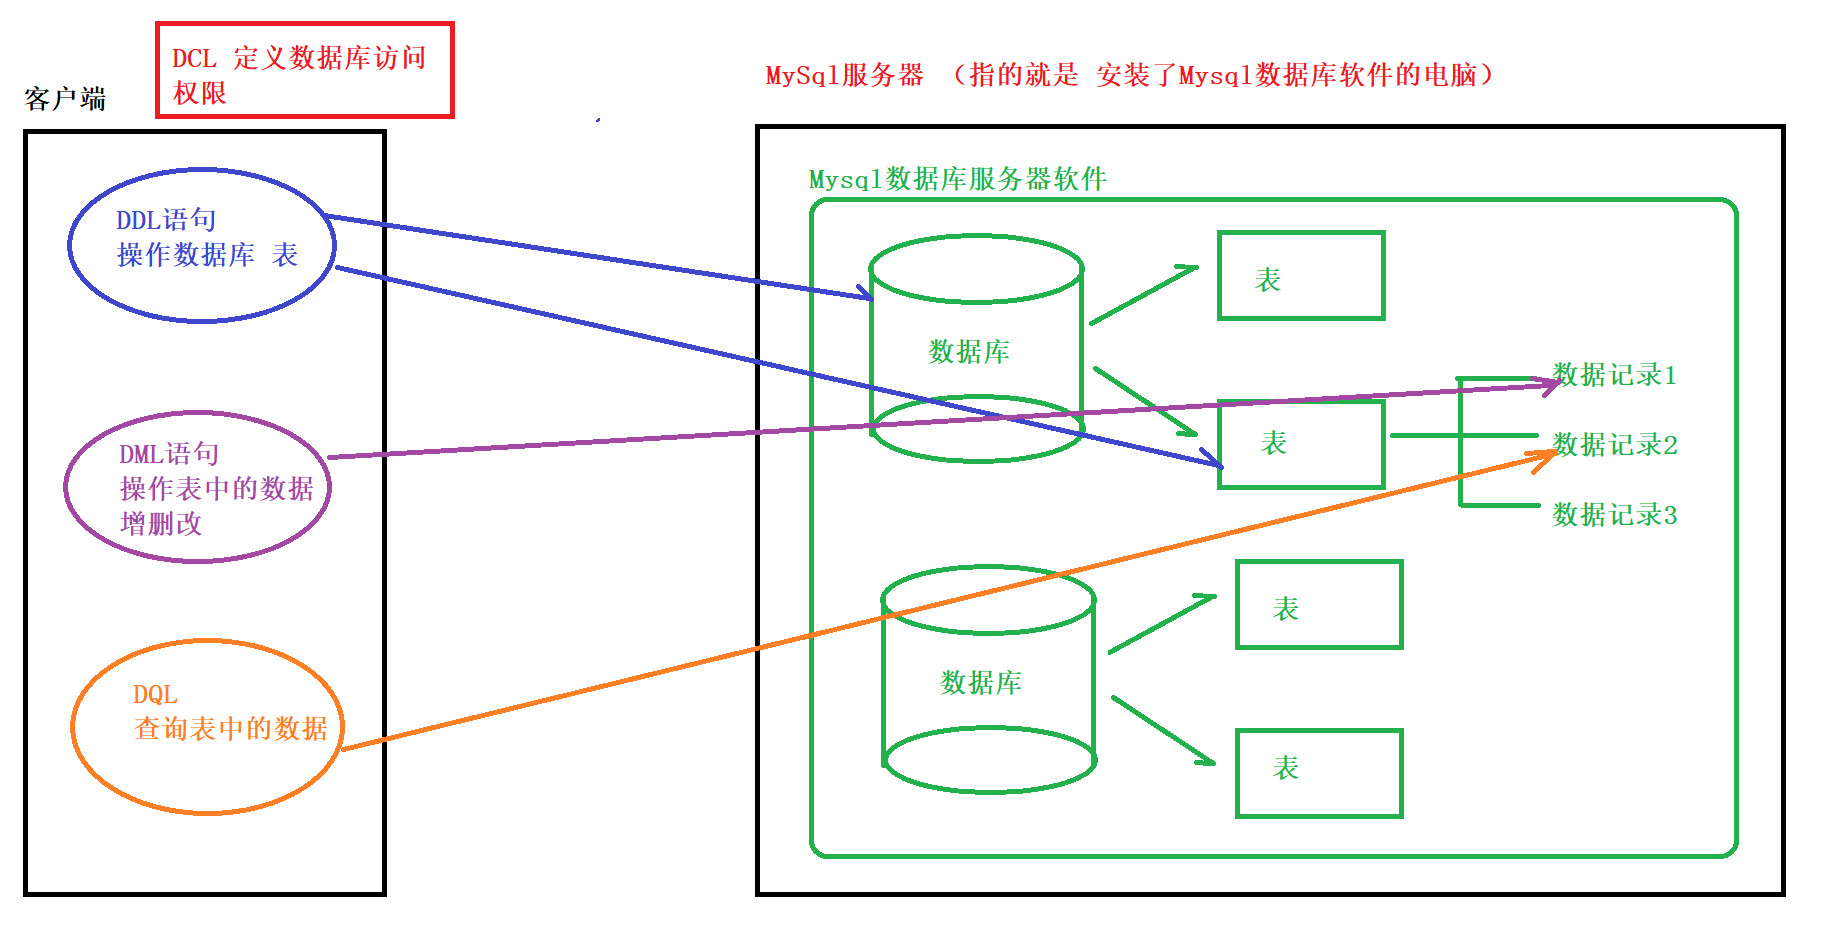
2.SQL 语句分类)
2.3 DDL 操作数据库
-- 查询所有的数据库列表
SHOW DATABASES;
2.3.1 MySQL 预设数据库
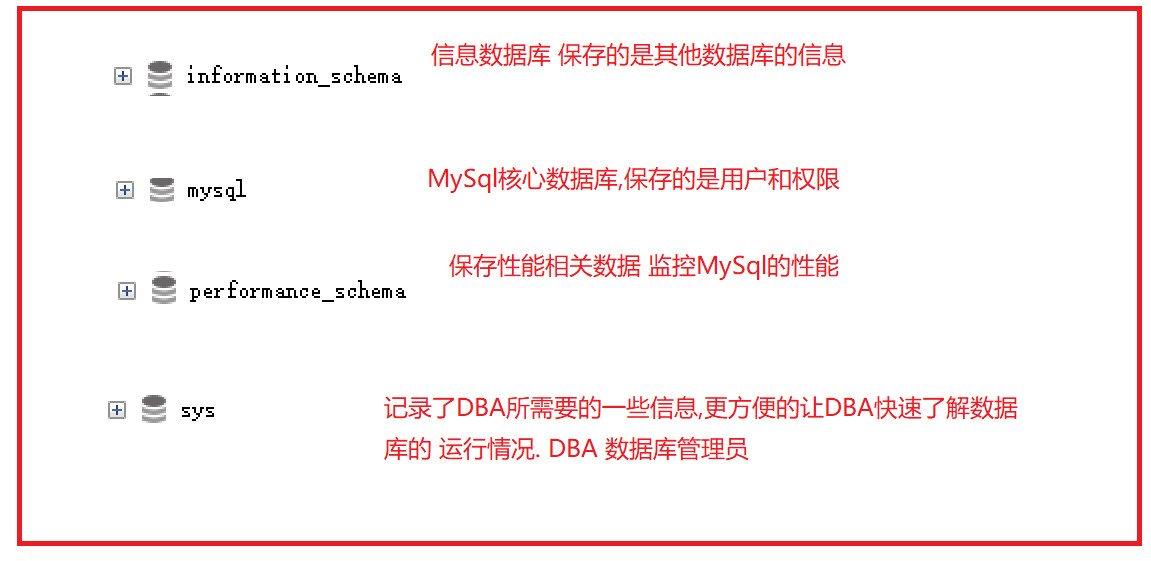
3.预设数据库)/*
对数据库操作的分类包含:
CRUD
C create 创建
R retrieve 查询
U update 修改
D delete 删除
使用数据库
*/
/*
创建数据库 方式1: 指定名称的数据库
latin1 编码
*/
CREATE DATABASE db1;
/*
指定字符集的方式创建数据库
utf8
*/
CREATE DATABASE db1_1 CHARACTER SET utf8;
/*
查看数据库
*/
-- 切换数据库
USE db1_1;
-- 查询当前正在使用的数据库
SELECT DATABASE();
-- 修改数据库的字符集
-- 语法格式 alter database 数据库名 character set utf8;
ALTER DATABASE db1 CHARACTER SET utf8;
-- 查询当前数据库的基本信息
SHOW CREATE DATABASE db1;
-- 删除数据库
-- 语法格式 drop database 数据库名称 将数据库从MySql中永久删除
DROP DATABASE db1_1; -- 慎用
2.4 DDL 操作数据表
2.4.1 MySQL 中常见的数据类型
| 类型 | 描述 |
|---|---|
| int | 整型 |
| double | 浮点型 |
| varchar | 字符串型 |
| date | 日期类型,给是为 yyyy-MM-dd ,只有年月日,没有时分秒 |
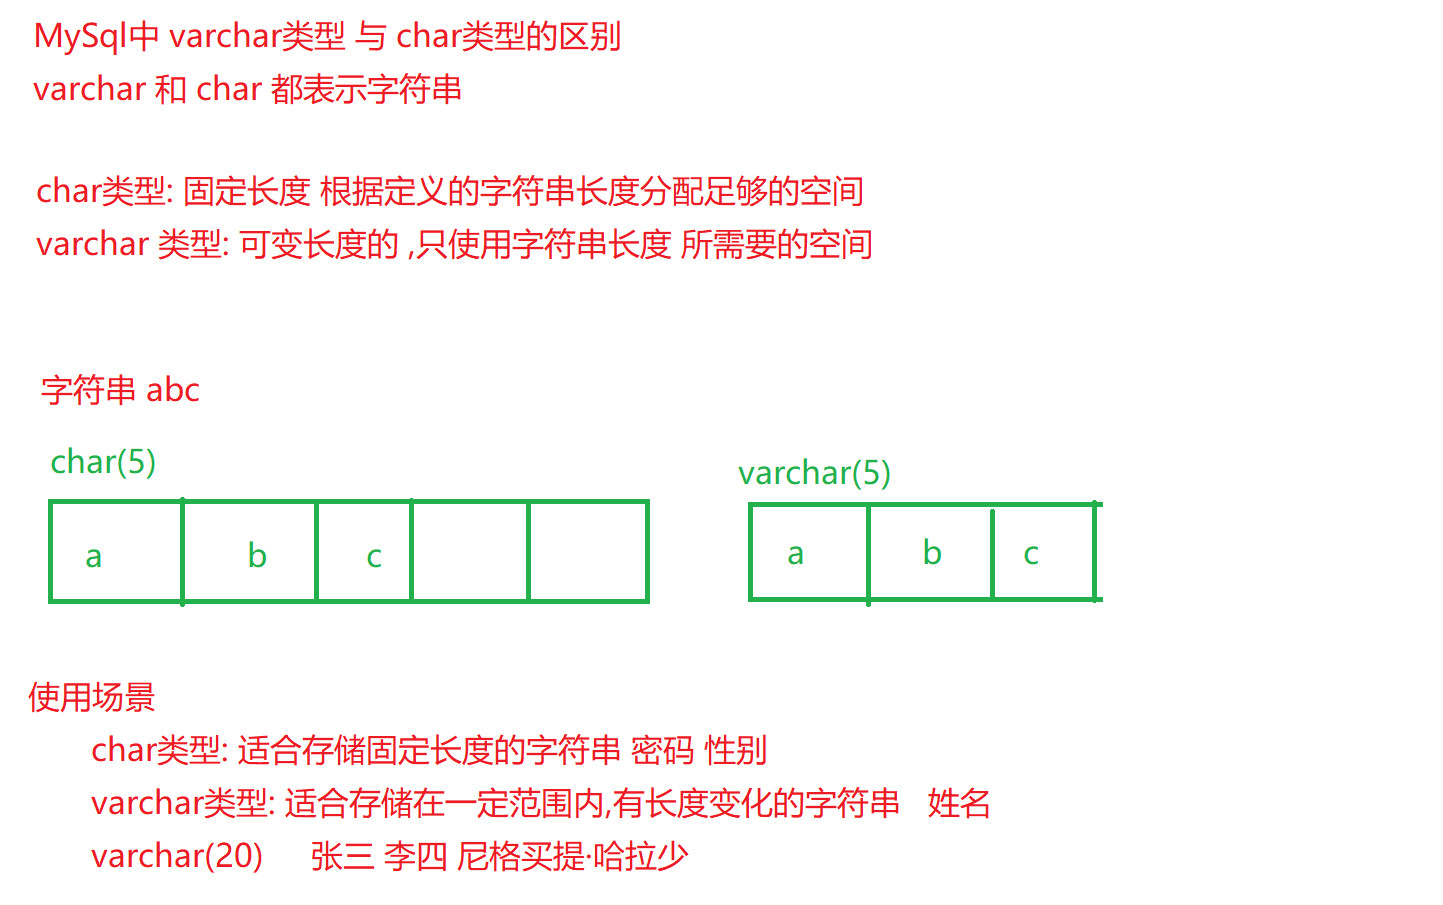
4.char与varchar类型)完整数据类型
2.4.2 DDL 创建、查看表
/*
	创建表的语法格式
	create table 表名(
	   字段名称1 字段类型(长度),
	   字段名称2 字段类型,
	   字段名称3 字段类型 最后一个列不要添加逗号
	);

	MySql中常见的数据类型
		int 整型
		double 浮点型
		varchar 字符串
		date 日期类型 年月日 没有时分秒 yyyy-MM-dd
		datetime 日期时间类型 yyyy-MM-dd HH:mm:ss

*/

-- 创建商品分类表
/*
	表名 category
		cid int 分类id
		cname varchar 分类的名称
*/

-- 选择要使用的数据库
USE db1;

-- 创建分类表
CREATE TABLE category(
	cid INT,
	cname VARCHAR(20)
);

-- 创建测试表
/*
	表名 test1
		tid int
		tdate date
*/
CREATE TABLE test1(
	tid INT,
	tdate DATE
);

-- 快速创建一个表结构相同的表(复制表结构)
-- 语法结构 create table 新表名称 like 旧表名称

-- 创建一个与test1表结构相同的 test2表
CREATE TABLE test2 LIKE test1;

-- 查看表结构
DESC test1;

-- 查看表
-- 查看当期那数据库中所有的数据表名
SHOW TABLES;

-- 查看创建表的 sql
SHOW CREATE TABLE category;

-- 查看表结构
DESC category;
2.4.3 DDL 删除表
-- 表的删除

-- 方式1: 将数据库中的某一张表永久删除
-- 语法格式: drop table 表名
DROP TABLE test1;

-- 方式2: 判断表是否存在, 如果存在就删除 如果不存在就不执行删除
DROP TABLE IF EXISTS test2;
2.4.4 DDL 修改表
/*
	修改表的名称
	修改表的字符集
	修改表中的某一列 (数据类型 名称 长度)
	向表中添加一列
	删除表中的某一列
*/

-- 修改表名称 语法格式: rename table 旧表名 to 新表名
RENAME TABLE category TO category1;

-- 修改表的字符集为 gbk
-- 语法格式: alter table 表名 character set 字符集
ALTER TABLE category1 CHARACTER SET gbk;

-- 向表中添加一个字段 关键字: add
-- 语法格式: alter table 表名 add 字段名称 字段类型(长度)
-- 添加分类描述字段
ALTER TABLE category1 ADD cdesc VARCHAR(20);


-- 修改表中列的类型或者长度 关键字 modify
-- 语法格式: alter table 表名 modify 字段名称 字段类型
-- 修改cdesc 字段的长度为 50
ALTER TABLE category1 MODIFY cdesc VARCHAR(50); -- 修改字段长度
ALTER TABLE category1 MODIFY cdesc CHAR(20); -- 修改字段类型

-- 修改列的名称 关键字: change
-- 语法格式: alter table 表名 change 旧列名 新列名 类型(长度)
-- 修改cdesc字段 名称改为 description varchar(30)
ALTER TABLE category1 CHANGE cdesc description VARCHAR(30);


-- 删除列 关键 drop
-- 语法格式: alter table 表名 drop 列名
ALTER TABLE category1 DROP description;
2.5 DML 操作数据(重点)
2.5.1 DML 插入数据
/*
	DML 对表中的数据进行 增删改
	增加
		语法格式: insert into 表名 (字段名1,字段名2...) values(字段值1,字段值2...)
*/
-- 创建学生表
CREATE TABLE student(
	sid INT,
	sname VARCHAR(20),
	age INT,
	sex CHAR(1),
	address VARCHAR(40)
);

-- 向学生表中插入数据

-- 方式1 插入全部字段 将所有字段名都写出来
INSERT INTO student (sid,sname,age,sex,address) VALUES(1,'孙悟空',18,'男','花果山');

-- 方式2 插入全部字段 不写字段名
INSERT INTO student VALUES(2,'孙悟饭',5,'男','地球');

-- 方式3 插入指定字段
INSERT INTO student (sid,sname) VALUES(3,'蜘蛛精');


-- 注意事项
-- 1.值与字段必须对应 个数&数据类型&长度 都必须一致
INSERT INTO student (sid,sname,age,sex,address) VALUES(4,'孙悟空',18,'男','花果山');

-- 2.在插入 varchar char date 类型的时候,必须要使用 单引号 或者双引号进行包裹
INSERT INTO student (sid,sname,age,sex,address) VALUES(4,'孙悟空',18,'男','花果山');

-- 3.如果插入空值 可以忽略不写 或者写 null
INSERT INTO student (sid,sname) VALUES(5,'唐僧');
INSERT INTO student (sid,sname,age,sex,address) VALUES(6,'八戒',NULL,NULL,NULL);
2.5.2 DML 修改数据
/*
	修改操作
		语法格式1: update 表名 set 列名 = 值
		语法格式2: update 表名 set 列名 = 值 [where 条件表达式: 字段名 = 值]
*/

-- 修改表中的所有的学生性别为女
UPDATE student SET sex = '女';  -- (慎用!!)

-- 带条件的修改 将 sid 为 1的数据,性别改为男
UPDATE student SET sex = '男' WHERE sid = 1;

-- 一次性修改多个列
-- 修改 sid 为 5 的这条数据, 年龄改为 20 , 地址改为 大唐
UPDATE student SET age = 20 , address = '大唐' WHERE sid = 5;
2.5.3 DML 删除数据
/*
	删除
		语法格式1: delete from 表名;
		语法格式2: delete from 表名 [where 条件];
*/

-- 删除 sid为 6的数据
DELETE FROM student WHERE sid = 6;

-- 删除所有数据
DELETE FROM student;


-- 删除所有数据的方式 两种
	-- 1. delete from 表; 不推荐, 对表中的数据逐条删除. 效率低
	-- 2. drop table 表; 推荐, 删除整张表
	-- 3. truncate table 表; 推荐, 删除整张表, 然后再创建一个一模一样的新表.

INSERT INTO student VALUES(1,'孙悟空',20,'男','花果山');
TRUNCATE TABLE student;
2.6 DQL 查询数据(重点)
2.6.1 DQL 简单查询
/*
	DQL
		简单查询
			select 列名 from 表名;
*/

-- 查询emp 表中的所有数据
SELECT * FROM emp; -- * 表示所有的列

-- 查询所有数据 只显示 id 和 name
SELECT eid, ename FROM emp;

-- 查询所有的数据,然后给列名 改为中文
-- 别名查询 使用关键字 as

SELECT
	eid AS '编号',
	ename AS '姓名',
	sex AS '性别',
	salary AS '薪资',
	hire_date AS '入职时间',
	dept_name '部门名称'  -- as 可以省略
FROM emp;

-- 查询一共有几个部门
SELECT dept_name FROM emp;
-- 去重操作 关键字 distinct
SELECT DISTINCT dept_name FROM emp;

-- 将我们的员工薪资数据 +1000 进行展示
SELECT ename, salary+1000 AS salary FROM emp;

-- 注意: 查询操作 不会对数据表中的数据进行修改,只是一种显示的方式.
2.6.2 DQL 条件查询
模糊查询 通配符
| 通配符 | 说明 |
|---|---|
| % | 表示匹配任意多个字符串 |
| _ | 表示匹配 一个字符 |
比较运算符
| 运算符 | 说明 |
|---|---|
| >, <, <=, >=, =, <>, != | 大于、小于、大于(小于)等于、不等于 |
| BETWEEN …AND… | 显示在某一区间的值 例如: 2000-10000之间: Between 2000 and 10000 |
| IN(集合) | 集合表示多个值,使用逗号分隔,例如: name in (悟空,八戒) in 中的每个数据都会作为一次条件,只要满足条件就会显示 |
| LIKE ‘%张%’ | 模糊查询 |
| IS NULL | 查询某一列为NULL的值, 注: 不能写 = NULL |
逻辑运算符
| 运算符 | 说明 |
|---|---|
| And && | 多个条件同时成立 |
| Or || | 多个条件任一成立 |
| Not | 不成立,取反 |
/*
	条件查询
	语法格式: select 列名 from 表名 where 条件表达式

	比较运算符
		>  <  <=   >=   =  <> !=
		BETWEEN  ...AND...
		IN(集合)
		LIKE
		IS NULL

	逻辑运算符
		And
		Or
		Not
*/
# 查询员工姓名为黄蓉的员工信息
-- 1.查哪张表	2.查哪些字段	3.查询条件
SELECT * FROM emp WHERE ename = '黄蓉'


# 查询薪水价格为5000的员工信息
SELECT * FROM emp WHERE salary = 5000;


# 查询薪水价格不是5000的所有员工信息
SELECT * FROM emp WHERE salary != 5000;
SELECT * FROM emp WHERE salary <> 5000;

# 查询薪水价格大于6000元的所有员工信息
SELECT * FROM emp WHERE salary > 6000;

# 查询薪水价格在5000到10000之间所有员工信息
SELECT * FROM emp WHERE salary BETWEEN 5000 AND 10000;
SELECT * FROM emp WHERE salary >= 5000 AND salary  <= 10000;

# 查询薪水价格是3600或7200或者20000的所有员工信息
SELECT * FROM emp WHERE salary = 3600 OR salary = 7200 OR salary = 20000;
-- 方式2 使用 in() 匹配括号中的参数
SELECT * FROM emp WHERE salary IN(3600,7200,20000);

/*
	like '_精'
		% 通配符 ,表示匹配任意多个字符串
		_ 通配符 ,表示匹配一个字符
*/

# 查询含有'精'字的所有员工信息
SELECT * FROM emp WHERE ename LIKE '%精%';

# 查询以'孙'开头的所有员工信息
SELECT * FROM emp WHERE ename LIKE '孙%';

# 查询第二个字为'兔'的所有员工信息
SELECT * FROM emp WHERE ename LIKE '_兔%';

# 查询没有部门的员工信息
-- select * from emp where dept_name = null; 错误方式
SELECT * FROM emp WHERE dept_name IS NULL;

# 查询有部门的员工信息
SELECT * FROM emp WHERE dept_name IS NOT NULL;

-- 条件查询 先取出表中的每条数据,满足条件的就返回,不满足的就过滤.
3 DQL 单表查询
3.0.3 DQL 排序查询
- 通过 ORDER BY 子句,可以将查询出的结果进行排序(排序只是显示效果,不会影响真实数据)
SELECT 字段名 FROM 表名 [WHERE 字段 = 值] ORDER BY 字段名 [ASC / DESC]ASC表示升序排序(默认)DESC表示降序排序
- 单列排序
- 只按照某一个字段进行排序, 就是单列排序
- 组合排序
- 同时对多个字段进行排序,如果第一个字段相同,就按照第二个字段进行排序,依此类推
/*
	排序
	使用 order by子句
	语法结构: 	select 字段名 from 表名 [where 字段名 = 值] order by 字段名称 [ASC/DESC]
		ASC 升序排序 (默认升序)
		DESC 降序排序
*/

-- 单列排序 按照某一个字段进行排序
-- 使用salary 字段 对emp表进行排序
SELECT * FROM emp ORDER BY salary; -- 默认升序
SELECT * FROM emp ORDER BY salary DESC; -- 降序排序


-- 组合排序 同时对多个字段进行排序
-- 在薪资的排序基础上,再去使用 id字段进行排序
SELECT * FROM emp ORDER BY salary DESC ,eid DESC;

-- 组合排序的特点: 如果第一个字段 值相同,就按照第二个字段进行排序.
3.0.4 DQL 聚合函数
- 之前我们做的查询都是横向查询,它们都是根据条件一行一行的进行判断,而使用聚合函数查询是纵向查询,它是对某一列的值进行计算,然后返回一个单一的值
- 另外聚合函数会忽略 NULL 空值
- 语法结构:
SELECT 聚合函数(字段名) FROM 表名;
| 聚合函数 | 作用 |
|---|---|
| count(字段) | 统计指定列不为 NULL 的记录行数 |
| sum(字段) | 计算指定列的数值和 |
| max(字段) | 计算指定列的最大值 |
| min(字段) | 计算指定列的最小值 |
| avg(字段) | 计算指定列的平均值 |
/*
	聚合函数
		作用:将一列数据作为一个整体,进行纵向的计算的

	常用的聚合函数
		count(字段) 统计记录数
		sum(字段) 求和操作
		max(字段) 求最大值
		min(字段) 求最小值
		avg(字段) 求平均值

	语法格式
		select 聚合函数(字段名) from 表名 [where 条件]
*/

#1 查询员工的总数
SELECT COUNT(*) FROM emp;
SELECT COUNT(1) FROM emp;
SELECT COUNT(eid) FROM emp;

-- count函数 在统计的时候回忽略空值
-- 注意 不要使用带空值的列 进行 count
SELECT COUNT(dept_name) FROM emp;

#2 查看员工总薪水、最高薪水、最小薪水、薪水的平均值
SELECT
	SUM(salary) AS '总薪水',
	MAX(salary) '最高薪水',
	MIN(salary) '最小薪水',
	AVG(salary) '平均薪水'
FROM emp;

#3 查询薪水大于4000员工的个数
SELECT COUNT(*) FROM emp WHERE salary > 4000;

#4 查询部门为'教学部'的所有员工的个数
SELECT COUNT(*) FROM emp WHERE dept_name = '教学部';

#5 查询部门为'市场部'所有员工的平均薪水
SELECT AVG(salary) FROM emp WHERE dept_name = '市场部';
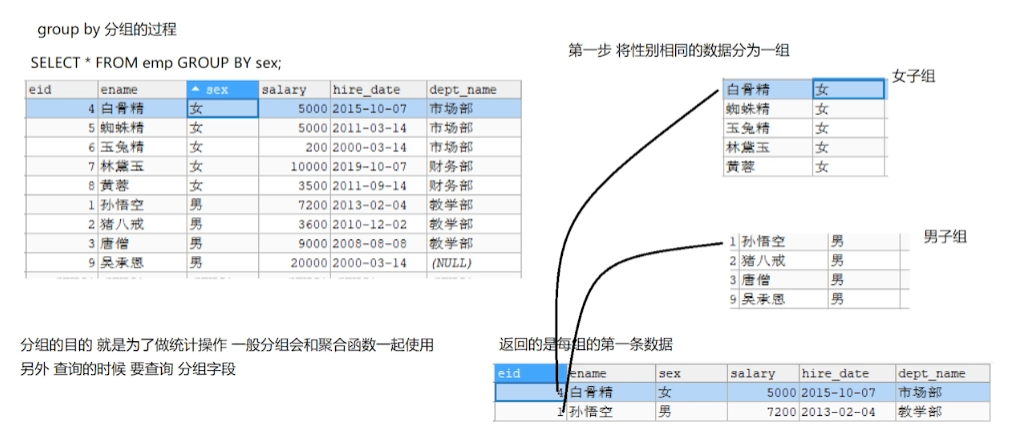
3.0.5 DQL 分组查询
- 分组查询指的是使用 GROUP BY 语句,对查询的信息进行分组,相同数据作为一组
- 语法格式:
SELECT 分组字段/聚合函数 FROM 表名 GROUP BY 分组字段 [HAVING 条件]
3.0.5.1 图解 GROUP BY 分组的过程
5.分组过程)注意
- 分组时可以查询要分组的字段,或者使用聚合函数进行统计操作
- 查询其他字段没有意义
/*
	分组查询 使用 group by 子句

	语法格式: select 分组字段/聚合函数 from 表名 group by 分组字段
*/

SELECT * FROM emp GROUP BY sex;

# 通过性别字段 进行分组,求各组的平均薪资
# 先分组,再组内平均
SELECT sex, AVG(salary) FROM emp GROUP BY sex;

#1.查询所有部门信息
SELECT dept_name AS '部门名称' FROM emp GROUP BY dept_name;

#2.查询每个部门的平均薪资
SELECT dept_name,AVG(salary) FROM emp GROUP BY dept_name;

#3.查询每个部门的平均薪资, 部门名称不能为 null
SELECT
	dept_name AS '部门名称',
	AVG(salary) AS '部门平均薪资'
FROM emp
WHERE dept_name IS NOT NULL
GROUP BY dept_name;

# 查询平均薪资大于6000的部门.
-- 1. 首先要分组求平均薪资
-- 2. 求出 平均薪资大于 6000的部门

-- 在分组之后 进行条件过滤 使用:  having 判断条件

SELECT
	dept_name,
	AVG(salary)
FROM emp
WHERE dept_name IS NOT NULL GROUP BY dept_name
HAVING	AVG(salary) > 6000;

/*
	where 与 having的区别
		where
			1.在分组前进行过滤
			2.where后面不能跟 聚合函数
		having
			1.是在分组后进行条件过滤
			2.having 后面可以写 聚合函数

*/
3.0.5.2 where 与 having的区别
- where
- where 进行分组前的过滤
- where 后面不能写聚合函数
- having
- having 是分组后的过滤
- having 后面可以写聚合函数
3.0.6 limit关键字
- limit 是限制的意思,用于限制返回的查询结果的行数(可以通过limit指定查询多少行数据)
- limit 语法是 MySql 的方言,用来完成分页
- 语法结构:
SELECT 字段1,字段2... FROM 表名 LIMIT offset, length;- limit offset, length;
- 关键字可以接受一个或者两个为 0 或者正整数的参数
- offset
- 起始行数, 从0开始记数, 如果省略 则默认为 0.
- length
- 返回的行数
- limit offset, length;
/*
	limit 通过limit 去指定要查询的数据的条数 行数

	语法格式
		select 字段 from 表名 limit offset, length;
	参数说明:
		offset: 起始行数 默认从0 开始计数
		length: 返回的行数 (要查询几条数据)
*/

# 查询emp表中的前 5条数据
SELECT * FROM emp LIMIT 0,5;
SELECT * FROM emp LIMIT 5;

# 查询emp表中 从第4条开始,查询6条
SELECT * FROM emp LIMIT 3 , 6;

-- limit 分页操作, 每页显示3条
SELECT * FROM emp LIMIT 0,3; -- 第一页
SELECT * FROM emp LIMIT 3,3; -- 第二页
SELECT * FROM emp LIMIT 6,3; -- 第三页 3-1=2 2*3=6

-- 分页公式 起始行数 = (当前页码 - 1) * 每页显示条数
4 约束
约束的作用:
- 对表中的数据进行进一步的限制,从而保证数据的正确性、有效性、完整性。
- 违反约束的不正确数据,将无法插入到表中
4.0.7 常见的约束
| 约束名 | 约束关键字 | 特点 | 作用 |
|---|---|---|---|
| 主键 | PRIMARY KEY | 唯一 非空 一个表只有一个主键 |
用来表示数据库中的每一条记录 |
| 唯一 | UNIQUE | 唯一 | |
| 非空 | NOT NULL | 该列不允许为空 | |
| 默认值 | DEFAULT | 设置该列默认值 | |
| 外键 | Foreign KEY |
4.0.8 主键约束
-
用途
- 通常针对业务去设计主键,每张表都设计一个主键 id
- 主键是给数据库和程序使用的,跟最终的客户无关,所以主键没有意义没有关系,只要能够保证不重复就好,比如身份证就可以作为主键。
-
语法格式
字段名 字段类型 primary key
/*
	主键约束
		特点	不可重复 唯一 非空
		作用	用来表示数据库中的每一条记录

	语法格式
		字段名	字段类型 primary key
*/

-- 方式1 创建一个带有主键的表
CREATE TABLE emp2(
	eid INT PRIMARY KEY,
	ename VARCHAR(20),
	sex CHAR(1)
);

DESC emp2;

-- 方式2 创建
DROP TABLE emp2; -- 删除表

CREATE TABLE emp2(
	eid INT,
	ename VARCHAR(20),
	sex CHAR(1),
	PRIMARY KEY(eid) -- 指定eid为主键
);

-- 方式3 创建表之后 再添加主键
CREATE TABLE emp2(
	eid INT,
	ename VARCHAR(20),
	sex CHAR(1)
);

-- 通过DDL语句 添加主键约束
ALTER TABLE emp2 ADD PRIMARY KEY(eid);
4.0.8.1 删除主键约束
-- 删除主键 DDL语句
ALTER TABLE emp2 DROP PRIMARY KEY;
4.0.8.2 主键的自增
/*
	主键的自增
		关键字:  auto_increment 主键的自动增长(字段类型必须是 整数类型)
*/

-- 创建主键自增的表
CREATE TABLE emp2(
	-- 主键自增
	eid INT PRIMARY KEY AUTO_INCREMENT,
	ename VARCHAR(20),
	sex CHAR(1)
);
-- 添加数据 观察主键变化
INSERT INTO emp2(ename,sex) VALUES('张三','男');
INSERT INTO emp2(ename,sex) VALUES('李四','男');
INSERT INTO emp2 VALUES(NULL,'王五','女');
INSERT INTO emp2 VALUES(NULL,'赵六','女');
4.0.8.3 修改主键自增的起始值
- 默认地 AUTO_INCREMENT 的开始值是 1,如果希望修改起始值,请使用下面的方式
-- 修改自增起始值

-- 重新创建自增主键的表, 自定义自增的其实位置
CREATE TABLE emp2(
	eid INT PRIMARY KEY AUTO_INCREMENT,
	ename VARCHAR(20),
	sex CHAR(1)
)AUTO_INCREMENT=100;
4.0.8.4 DELETE 和 TRUNCATE 对自增长的影响
- DELETE
- 只是删除表中所有数据,对自增没有影响
- TRUNCATE
- truncate 是将整个表删除掉,然后创建一个新的表
- 自增的值,重新从 1 开始
- 即使之前设置过起始值,也会从 1 开始
/*
	DELETE和TRUNCATE对自增长的影响

	delete 删除表中所有数据, 将表中的数据逐条删除.
	truncate 删除表中的所有数据, 是将整个表删除,然后再创建一个结构相同表.
*/

-- delete 方式删除所有数据
DELETE FROM emp2; -- delete 删除对自增是没有影响

INSERT INTO emp2(ename,sex) VALUES('刘一','男'); -- 102
INSERT INTO emp2(ename,sex) VALUES('陈二','女'); -- 103


-- truncate 删除所有数据
TRUNCATE TABLE emp2; -- 自增从1开始

INSERT INTO emp2(ename,sex) VALUES('刘一','男'); -- 1
INSERT INTO emp2(ename,sex) VALUES('陈二','女'); -- 2
4.0.9 非空约束
/*
	非空约束
		特点 表中某一列不予许为空

	语法格式
		字段名 字段类型 not null
*/

CREATE TABLE emp2(
	eid INT PRIMARY KEY AUTO_INCREMENT,
	-- 将 ename字段 添加了 非空约束
	ename VARCHAR(20) NOT NULL,
	sex CHAR(1)
);
4.0.10 唯一约束
/*
	唯一约束
		特点: 表中的某一列不能够重复 (对null值 不做唯一判断)

	语法格式
		字段名 字段类型 unique
*/
-- 创建 emp3表 为ename 字段添加 唯一约束
CREATE TABLE emp3(
	eid INT PRIMARY KEY ,
	ename VARCHAR(20) UNIQUE,
	sex CHAR(1)
);

-- 测试唯一约束
INSERT INTO emp3 VALUES(1,'刘一','女');

-- Duplicate entry '张百万' for key 'ename' 不能重复
INSERT INTO emp3 VALUES(2,'陈二','女');

-- 唯一约束的值 可以为 null
INSERT INTO emp3 VALUES(2,NULL,'女');
4.0.11 主键约束和唯一约束的区别
- 主键约束和唯一约束的区别
- 主键约束:唯一,不能为空
- 唯一约束:唯一,可以为空
- 一个表中只能有一个主键,但是可以有多个唯一约束
4.0.12 默认值
/*
	默认值
		特点 用来指定 某一列的默认值

	语法格式
		字段名 字段类型 default 默认值
*/
--  创建 emp4 表, 指定 sex 默认为 女
CREATE TABLE emp4(
	eid INT PRIMARY KEY,
	ename VARCHAR(20),
	sex CHAR(1) DEFAULT '女'
);

INSERT INTO emp4(eid,ename) VALUES(1,'刘一');
INSERT INTO emp4(eid,ename) VALUES(2,'陈二');

-- 不使用默认值
INSERT INTO emp4(eid,ename,sex) VALUES(3,'张三','男');
5 MySQL 多表、外键
5.1 多表
- 单表的问题
- 数据记录不做分类,大量空字段
- 检索、查看数据不方便
- 冗余,同一个字段中出现大量的重复数据
- 多表的问题
- 当我们在员工表的 dept_id 里面输入不存在的部门 id ,数据依然可以添加,显然这是不合理的
- 实际上我们应该保证,员工表所添加的 dept_id ,必须在部门表中存在
- 外键约束就是为此而设计
5.2 外键约束
- 外键指的是在从表中与主表的主键对应的那个字段,比如员工表的 dept_id ,就是外键
- 多表关系中的主表和从表
- 主表:主键 id 所在的表,约束别人的表
- 从表:外键所在的表,被约束的表
- 多表关系中的主表和从表
- 使用外键约束可以让两张表之间产生一个对应关系,产生强制性的外键数据检查,从而保证了数据的完整性和一致性,
5.2.1 创建外键约束
- 新建表时添加外键
[CONSTRAINT] [外键约束名称] FOREIGN KEY(外键字段名) REFERENCES 主表名(主键字段名)
- 已有表添加外键
ALTER TABLE 从表 ADD [CONSTRAINT] [外键约束名称] FOREIGN KEY (外键字段名) REFERENCES 主表(主 键字段名);- 可以省略外键名称, 系统会自动生成一个
ALTER TABLE employee ADD FOREIGN KEY (dept_id) REFERENCES department (id);
-- 创建部门表
-- 一方,主表
CREATE TABLE department(
	 id INT PRIMARY KEY AUTO_INCREMENT,
	 dep_name VARCHAR(30),
	 dep_location VARCHAR(30)
);

-- 创建员工表
-- 多方 ,从表
CREATE TABLE employee(
	eid INT PRIMARY KEY AUTO_INCREMENT,
	ename VARCHAR(20),
	age INT,
	dept_id INT
);


-- 添加2个部门
INSERT INTO department VALUES(NULL, '研发部','广州'),(NULL, '销售部', '深圳');
SELECT * FROM department;

-- 添加员工,dep_id表示员工所在的部门
INSERT INTO employee (ename, age, dept_id) VALUES ('刘一', 20, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('陈二', 21, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('张三', 20, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('李四', 20, 2);
INSERT INTO employee (ename, age, dept_id) VALUES ('王五', 22, 2);
INSERT INTO employee (ename, age, dept_id) VALUES ('赵六', 18, 2);

SELECT * FROM employee;

-- 插入一条 不存在部门的数据
INSERT INTO employee (ename,age,dept_id) VALUES('无名',35,3);


/*
	外键约束
		作用: 外键约束可以让两张表之间产生有一个对应的关,从而保证了主从表引用的完整性

	外键
		外键指的是在从表中与主表的主键对应的字段

	主表和从表
		主表 主键id所在的表 ,一的一方
		从表 外键字段所在的表,多的一方

	添加外键约束的语法格式
		1.创建表的时候添加外键
		create table 表名(
			字段...
			[constraint] [外键约束名] foreign key(外键字段名) references 主表(主键字段)
		);

*/

-- 创建员工表 添加外键
CREATE TABLE employee(
	eid INT PRIMARY KEY AUTO_INCREMENT,
	ename VARCHAR(20),
	age INT,
	dept_id INT, -- 外键字段 指向了主表的主键
	-- 添加外键约束
	CONSTRAINT emp_dept_fk FOREIGN KEY(dept_id) REFERENCES department(id)
);

-- 正常添加数据 (从表外键 对应主表主键)
INSERT INTO employee (ename, age, dept_id) VALUES ('刘一', 20, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('陈二', 21, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('张三', 20, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('李四', 20, 2);
INSERT INTO employee (ename, age, dept_id) VALUES ('王五', 22, 2);
INSERT INTO employee (ename, age, dept_id) VALUES ('赵六', 18, 2);

-- 插入一条错误的数据
-- 添加外键约束之后 就会产生一个强制的外键约束检查 保证数据的完整性和一致性
INSERT INTO employee (ename, age, dept_id) VALUES ('错误', 18, 3);


-- 创建表之后添加外键
-- 语法格式 alter table 从表 add CONSTRAINT emp_dept_fk FOREIGN KEY(dept_id) REFERENCES department(id)

-- 简写 不写外键约束名 自动生成的外键约束 employee_ibfk_1
ALTER TABLE employee ADD FOREIGN KEY(dept_id) REFERENCES department(id)
5.2.2 删除外键约束
alter table 从表 drop foreign key 外键约束名称
/*
	删除外键约束
	语法格式
		alter table 从表 drop foreign key 外键约束的名称

*/

-- 删除 employee表中 外键
ALTER TABLE employee DROP FOREIGN KEY emp_dept_fk;
注意
- 从表外键类型必须与主表主键类型一致,否则创建失败
- 添加数据时,应该先添加主表中的数据
- 删除数据时,应该先删除从表中的数据
5.2.3 级联删除操作(慎用、了解)
- 如果想实现删除主表数据的同时,也删除掉相关的从表数据,可以使用级联删除
- 级联删除的使用
- 在添加外键约束的同时,添加级联删除
ON DELETE CASCADE
- 在添加外键约束的同时,添加级联删除
/*
	级联删除
		指的是在删除主表的数据的同时,可以删除与之相关的从表中的数据

	级联删除
		on delete cascade
*/
-- 重新创建添加级联操作
CREATE TABLE employee(
	eid INT PRIMARY KEY AUTO_INCREMENT,
	ename VARCHAR(20),
	age INT,
	dept_id INT,
	CONSTRAINT emp_dept_fk FOREIGN KEY(dept_id) REFERENCES department(id)
	-- 添加级联删除
	ON DELETE CASCADE
);

-- 添加数据
INSERT INTO employee (ename, age, dept_id) VALUES ('刘一', 20, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('陈二', 21, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('张三', 20, 1);
INSERT INTO employee (ename, age, dept_id) VALUES ('李四', 20, 2);
INSERT INTO employee (ename, age, dept_id) VALUES ('王五', 22, 2);
INSERT INTO employee (ename, age, dept_id) VALUES ('赵六', 18, 2);

-- 删除部门编号为 2 的数据
DELETE FROM department WHERE id = 2;
5.3 表与表之间的三种关系
-
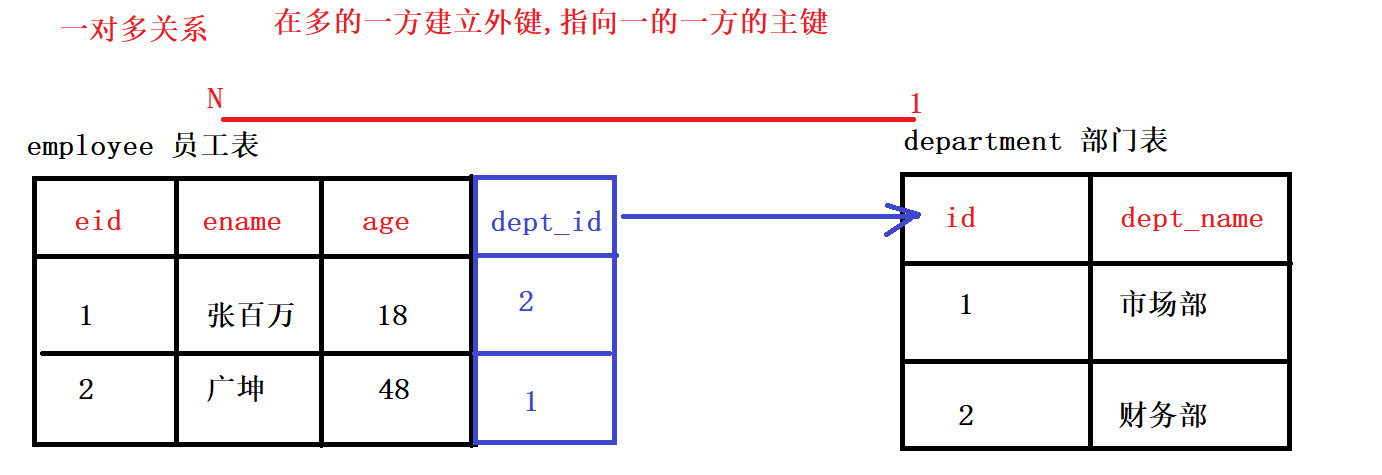
一对多关系
- 最常见的关系,学生对班级,员工对部门
-
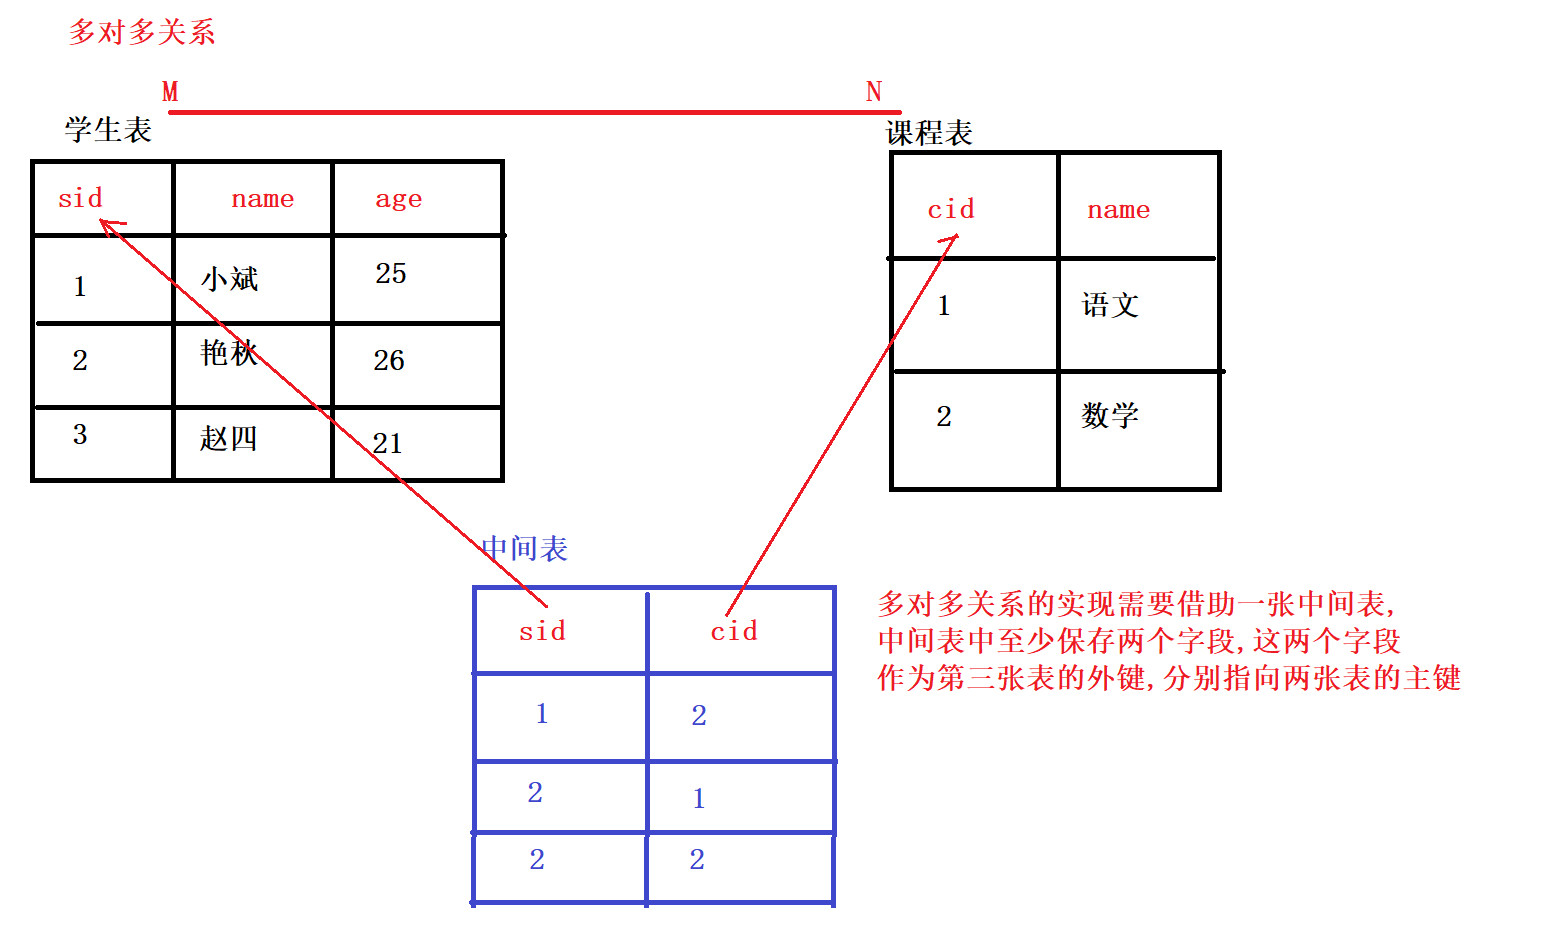
多对多关系
- 学生与课程,用户与角色
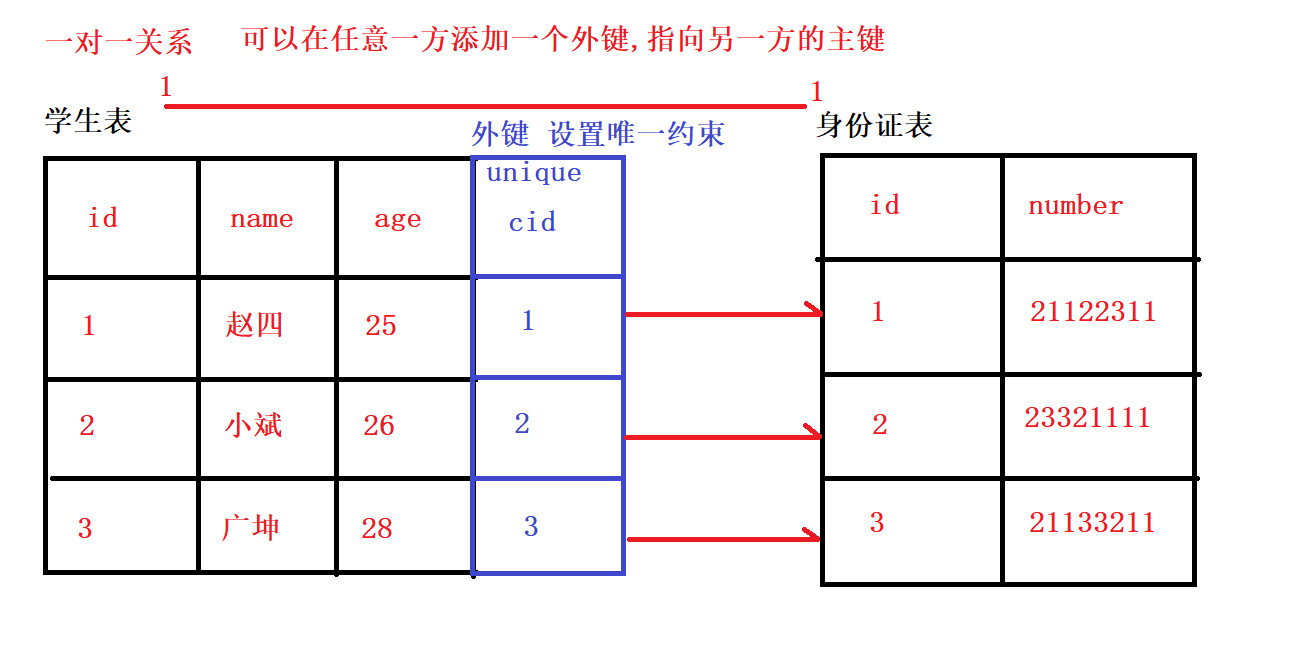
-
一对一关系
- 使用较少,因为一对一关系可以合成为一张表
5.3.1 一对多
一对多建表原则 在从表(多方)创建一个字段,字段作为外键指向主表(一方)的主键
6.一对多)/*
表与表之间的三种关系
一对多关系(1:n 常见): 班级和学生 部门和员工
多对多关系(n:n 常见): 学生与课程 演员和角色
一对一关系(1:1 了解): 身份证 和 人
*/
-- 一对多关系 省表与市表
-- 创建省表 主表 一的一方
CREATE TABLE province(
id INT PRIMARY KEY AUTO_INCREMENT,
NAME VARCHAR(20),
description VARCHAR(20)
);
-- 创建市表 从表 中 外键字段指向 主表的主键
CREATE TABLE city(
cid INT PRIMARY KEY AUTO_INCREMENT,
NAME VARCHAR(20),
description VARCHAR(20),
-- 创建外键 添加外键约束
pid INT,
FOREIGN KEY(pid) REFERENCES province(id)
);
5.3.2 多对多
多对多建表原则 需要创建第三张表,中间表中至少两个字段,这两个字段分别作为外键指向各自一方的 主键。
7.多对多)-- 多对多关系 演员与角色
-- 演员表
CREATE TABLE actor(
id INT PRIMARY KEY AUTO_INCREMENT,
NAME VARCHAR(20)
);
-- 角色表
CREATE TABLE role(
id INT PRIMARY KEY AUTO_INCREMENT,
NAME VARCHAR(20)
);
-- 创建中间表
CREATE TABLE actor_role(
-- 中间表的主键
id INT PRIMARY KEY AUTO_INCREMENT,
-- aid 字段 指向 actor表的主键
aid INT,
-- rid 指向 role表的主键
rid INT
);
-- 添加外键约束
-- aid字段添加外键约束
ALTER TABLE actor_role ADD FOREIGN KEY(aid) REFERENCES actor(id);
-- rid字段添加外键约束
ALTER TABLE actor_role ADD FOREIGN KEY(rid) REFERENCES role(id);
5.3.3 一对一
一对一建表原则: 外键唯一,主表的主键和从表的外键(唯一),形成主外键关系,外键唯一:UNIQUE
8.一对一)
5.4 DQL 多表查询
5.4.1 数据准备
CREATE DATABASE db3_2 CHARACTER SET utf8;

#分类表 (一方 主表)
CREATE TABLE category (
  cid VARCHAR(32) PRIMARY KEY ,
  cname VARCHAR(50)
);

#商品表 (多方 从表)
CREATE TABLE products(
  pid VARCHAR(32) PRIMARY KEY ,
  pname VARCHAR(50),
  price INT,
  flag VARCHAR(2),		#是否上架标记为:1表示上架、0表示下架
  category_id VARCHAR(32),
  -- 添加外键约束
  FOREIGN KEY (category_id) REFERENCES category (cid)
);

#分类数据
INSERT INTO category(cid,cname) VALUES('c001','家电');
INSERT INTO category(cid,cname) VALUES('c002','鞋服');
INSERT INTO category(cid,cname) VALUES('c003','化妆品');
INSERT INTO category(cid,cname) VALUES('c004','汽车');

#商品数据
INSERT INTO products(pid, pname,price,flag,category_id) VALUES('p001','小米电视机',5000,'1','c001');
INSERT INTO products(pid, pname,price,flag,category_id) VALUES('p002','格力空调',3000,'1','c001');
INSERT INTO products(pid, pname,price,flag,category_id) VALUES('p003','美的冰箱',4500,'1','c001');

INSERT INTO products (pid, pname,price,flag,category_id) VALUES('p004','篮球鞋',800,'1','c002');
INSERT INTO products (pid, pname,price,flag,category_id) VALUES('p005','运动裤',200,'1','c002');
INSERT INTO products (pid, pname,price,flag,category_id) VALUES('p006','T恤',300,'1','c002');
INSERT INTO products (pid, pname,price,flag,category_id) VALUES('p007','冲锋衣',2000,'1','c002');

INSERT INTO products (pid, pname,price,flag,category_id) VALUES('p008','神仙水',800,'1','c003');
INSERT INTO products (pid, pname,price,flag,category_id) VALUES('p009','大宝',200,'1','c003');
5.4.2 笛卡尔积
假设集合A={a, b},集合B={0, 1, 2},则两个集合的笛卡尔积为 {(a, 0), (a, 1), (a, 2), (b, 0), (b, 1), (b, 2)}
/*
	笛卡尔积
*/

-- 多表查询 交叉连接查询 的查询结果会产生 笛卡尔积 是没有使用价值的.
SELECT * FROM products ,category;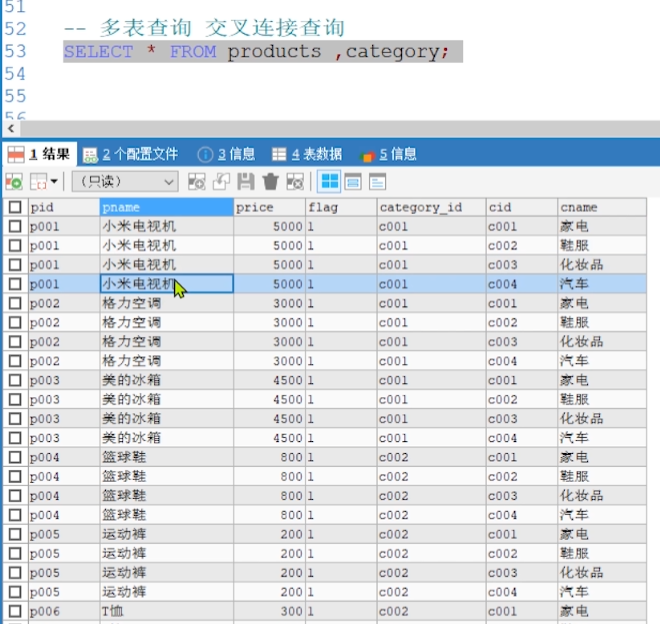
9.笛卡尔积)
5.4.3 内连接查询
通过指定的条件去匹配两张表中的数据,匹配上就显示,匹配不上就不显示
5.4.4 隐式内连接
SELECT 字段名 FROM 左表, 右表 WHERE 连接条件;
/*
	内连接查询
		特点 通过指定的条件 去匹配俩张表中的内容, 匹配不上的就不显示

		隐式内连接
			语法格式: select 字段名... from 左表,右表 where 连接条件

		显式内连接
			语法格式: select 字段名... from 左表 [inner] join 右表 on 连接条件
			inner 可以省略

*/

-- 1.查询所有商品信息和对应的分类信息
-- 隐式内连接
SELECT * FROM products , category WHERE category_id = cid;

-- 2.查询商品表的商品名称 和 价格,以及商品的分类信息
-- 多表查询中 可以使用给表起别名的方式 简化查询
SELECT
	p.`pname`,
	p.`price`,
	c.`cname`
FROM products p,category c WHERE p.`category_id` = c.`cid`;

--  查询 格力空调是属于哪一分类下的商品
SELECT
	p.`pname`,
	c.`cname`
FROM products p, category c WHERE p.`category_id` = c.`cid` AND p.`pid` = 'p002';
5.4.5 显式内连接
SELECT 字段名 FROM 左表 [INNER] JOIN 右表 ON 条件
-- 1.查询所有商品信息和对应的分类信息
-- 显式内连接
SELECT
*
FROM products p
INNER JOIN category c ON p.`category_id` = c.`cid`;

-- 2.查询鞋服分类下,价格大于500的商品名称和价格
/*
	查询之前要确定几件事情
		1.查询几张表 products &  category
		2.表的连接条件 p.`category_id` = c.`cid`; 从表.外键 = 主表.主键
		3.查询所用到的字段  商品名称  价格
		4.查询的条件 分类 = 鞋服,  价格 > 500
*/

SELECT
	p.`pname`,
	p.`price`
FROM products p
INNER JOIN category c ON p.`category_id` = c.`cid`
WHERE p.`price` > 500 AND c.`cname` = '鞋服';
5.4.6 左外连接查询
以左表为基准,匹配右边表中的数据
如果匹配的上,就展示匹配到的数据
如果匹配不到,左表中的数据正常展示,右边的展示为 null
/*
	外连接查询
		左外连接
			语法格式 关键字 left [outer] join
				select 字段名 from 左表 left join 右表 on 连接条件
			左外连接的特点
				以左表为基准 匹配右表中的数据 如果能匹配上就显示
				如果匹配不上, 左表中的数据正常显示,右表数据显示为null

		右外连接
			语法格式 关键字 right [outer]  join
				select 字段名 from 左表 right join 右表 on 条件
			右外连接的特点
				以右表为基准 匹配左表中的数据 如果能够匹配上 就显示
				如果匹配不到 右表中的数据就正常显示 左表显示null
*/

-- 左外连接查询
SELECT
*
FROM category c
LEFT JOIN products p ON c.`cid` = p.`category_id`;

--  查询每个分类下的商品个数
/*
	1.查询的表
	2.查询的条件 分组 统计
	3.查询的字段 分类 分类下商品个数信息
	4.表的连接条件
*/

SELECT
	c.`cname`,
	COUNT(p.`pid`)
FROM
-- 表连接
category c  LEFT JOIN products p ON c.`cid` = p.`category_id`
-- 分组
GROUP BY c.`cname`;
5.4.7 右外连接查询
以右表为基准,匹配左边表中的数据
如果能匹配到,展示匹配到的数据
如果匹配不到,右表中的数据正常展示,左边展示为 null
-- 右外连接查询
SELECT * FROM products p RIGHT JOIN category c ON p.`category_id` = c.`cid`;
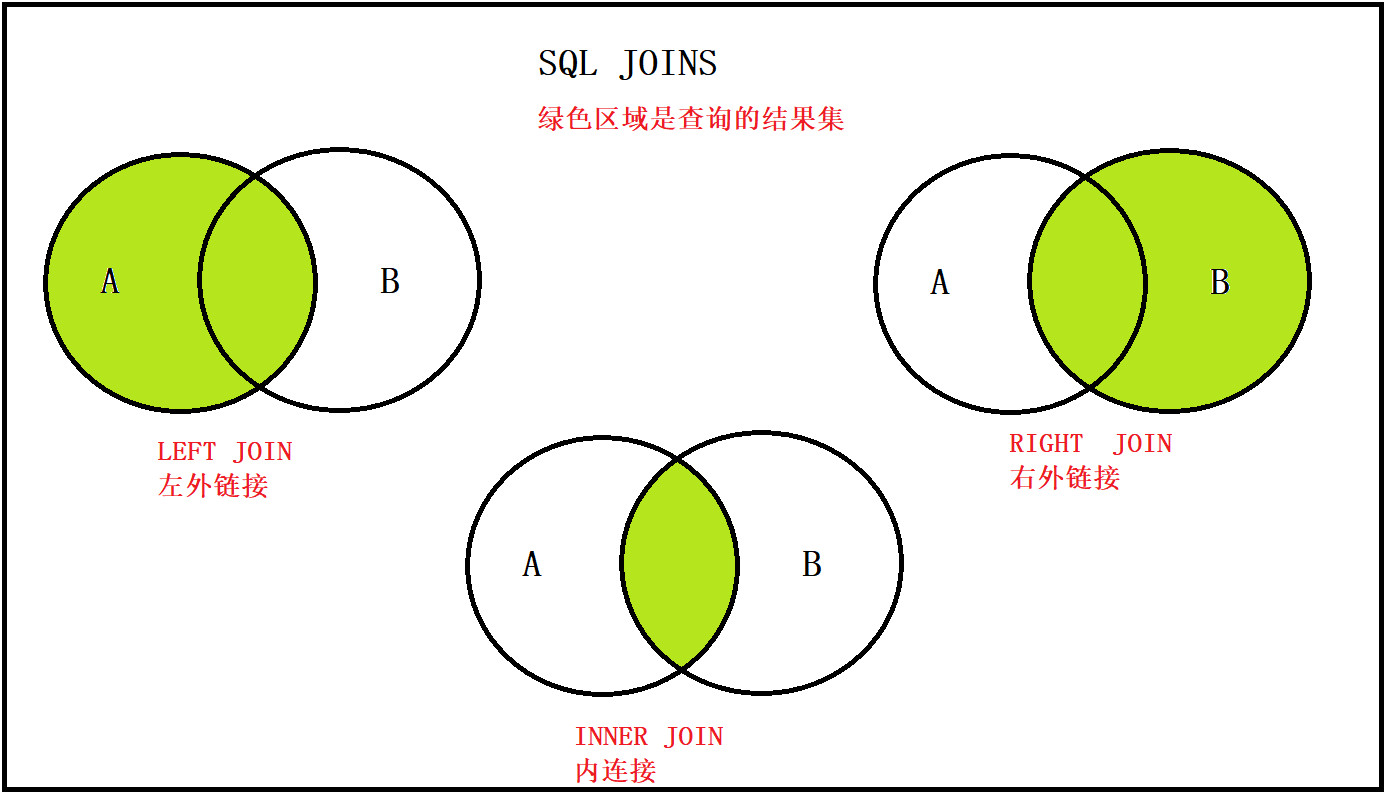
5.4.8 总结
- 内连接: inner join
- 只获取两张表中,交集部分的数据
- 左外连接: left join
- 以左表为基准,查询左表的所有数据,以及与右表有交集的部分
- 右外连接: right join
- 以右表为基准,查询右表的所有的数据,以及与左表有交集的部分
10.多表查询)
5.5 子查询
一条 select 查询语句的结果,作为另一条 select 语句的一部分
/*
	子查询 subQuery
		一条select语句的结果,作为另外一条select语句的一部分.

	子查询的特点
		子查询必须要放在 小括号中
		子查询作为父查询的条件使用(更多的时候)
*/

-- 查询价格最高的商品信息
-- 1.查询出最高的价格
SELECT MAX(price) FROM products ; -- 5000

-- 2.根据最高价格 查出商品信息
SELECT * FROM products WHERE price = 5000;

-- 使用一条SQL完成 子查询方式
SELECT * FROM products WHERE price = (SELECT MAX(price) FROM products );- 特点
- 子查询必须放在小括号中
- 子查询一般作为父查询的查询条件使用
- 分类
- where 型子查询:
- 将子查询的结果,作为父查询的比较条件
- from 型子查询:
- 将子查询的结果,作为 一张表,提供给父层查询使用
- exists 型子查询:
- 子查询的结果是单列多行,类似一个数组,父层查询使用 IN 函数,包含子查询的结果
- where 型子查询:
5.5.1 子查询的结果作为查询条件
SELECT 查询字段 FROM 表 WHERE 字段=(子查询);
-- 子查询作为查询条件

-- 1. 查询化妆品分类下的 商品名称 商品价格
-- 查询出化妆品分类的 id
SELECT cid FROM category WHERE cname = '化妆品'; -- c003

-- 2.根据化妆品id 查询对应商品信息
SELECT
	p.`pname`,
	p.`price`
FROM products p
WHERE p.`category_id` = (SELECT cid FROM category WHERE cname = '化妆品');

-- 查询小于平均价格的商品信息
-- 1.求出平均价格
SELECT AVG(price) FROM products; -- 1866

-- 2.获取小于平均价格的商品信息
SELECT
*
FROM products
WHERE price < (SELECT AVG(price) FROM products);
5.5.2 子查询的结果作为一张表
SELECT 查询字段 FROM (子查询)表别名 WHERE 条件;
当子查询作为一张表的时候,需要起别名,否则无法访问表中的字段。
-- from型子查询方式

-- 查询商品中,价格大于500的商品信息,包括 商品名称 商品价格 商品所属分类名称
SELECT * FROM category;

SELECT
	p.`pname`,
	p.`price`,
	c.cname
FROM products p
-- 注意 子查询的结果作为一张表时,要起一个别名 否则无法访问表中的字段
INNER JOIN (SELECT * FROM category) c ON p.`category_id` = c.cid
WHERE p.`price` > 500;
5.5.3 子查询结果是单列多行
子查询的结果类似一个数组,父层查询使用 IN 函数,包含子查询的结果
/*
	子查询的结果是单列多行, 作为父查询的 in 函数中的条件使用
	语法格式
		select 字段名 from 表名 where 字段 in(子查询);
*/
-- 查询价格小于两千的商品,来自于哪些分类(名称)

-- 1.查询小于两千的商品的 分类id
SELECT DISTINCT category_id FROM products WHERE price < 2000;

-- 2.根据分类的id 查询 分类的信息
SELECT * FROM category
WHERE cid IN
(SELECT DISTINCT category_id FROM products WHERE price < 2000);


-- 查询家电类 与 鞋服类下面的全部商品信息
-- 1.首先要获取 家电类和鞋服类 分类id
SELECT cid FROM category WHERE cname IN('家电','鞋服');

-- 2.根据 分类id 查找商品信息
SELECT
*
FROM products WHERE category_id IN
(SELECT cid FROM category WHERE cname IN('家电','鞋服'));
5.5.4 子查询小结
- 子查询如果查出的是一个字段(单列),那就在 where 后面作为条件使用
- 子查询如果查询出的是多个字段(多列),就当做一张表使用(要起别名)
6 数据库设计
6.1 数据库设计三范式
- 三范式就是设计数据库的规则
- 为了建立冗余较小、结构合理的数据库,设计数据库时必须遵循一定的规则。在关系型数据库中这种规则就称为范式。范式是符合某一种设计要求的总结。要想设计一个结构合理的关系型数据库,必须满足一定的范式
- 满足最低要求的范式是第一范式(1NF)。在第一范式的基础上进一步满足更多规范要求的称为第二范式(2NF) , 其余范式以此类推。一般说来,数据库只需满足第三范式(3NF)就行了
6.1.1 第一范式 1NF
- 原子性,做到列不可拆分
- 第一范式是最基本的范式。数据库表里面字段都是单一属性的,不可再分,如果数据表中每个字段都是不可再分的最小数据单元,则满足第一范式。
6.1.2 第二范式 2NF
- 在第一范式的基础上更进一步,目标是确保表中的每列都和主键相关。
- 一张表只能描述一件事。
6.1.3 第三范式 3NF
- 消除传递依赖表的信息,如果能够被推导出来,就不应该单独的设计一个字段来存放
6.2 数据库设计反三范式
- 反范式化指的是通过增加冗余或重复的数据来提高数据库的读性能
- 设计数据库时,某一个字段属于一张表,但它同时出现在另一个或多个表,且完全等同于它在其本来所属表的意义表示,那么这个字段就是一个冗余字段
- 浪费存储空间,节省查询时间(以空间换时间)
6.3 总结
创建一个关系型数据库设计,我们有两种选择
- 尽量遵循范式理论的规约,尽可能少的冗余字段,让数据库设计看起来精致、优雅、巧妙
- 合理的加入冗余字段这个润滑剂,减少 join ,让数据库执行性能更高,速度更快。